Hoofdstuk 8
Trage clients en verloren verbindingen
Eén trage kijker houdt iedereen op
Scorebord v1 werkt, en het heeft een zwakte die je in scoreboard_server.py kunt lezen. apply_score neemt de lock van het bord, hoogt de versie op en roept broadcast aan, die de nieuwe snapshot naar elke kijker stuurt, de een na de ander, voordat de lock wordt vrijgegeven. Pas nadat apply_score is teruggekeerd, stuurt scorekeeper_handler zijn antwoord. Elk antwoord aan de scorebijhouder wacht dus totdat elke kijker de update is gestuurd. Deze les vraagt wat er gebeurt als een van die sends traag is.
Als een send wacht
Het antwoord kwam je tegen in Networks with Python: sendall keert terug zodra het send van de bibliotheek werkt onderliggend op dezelfde manier. Zolang de andere kant blijft lezen, lopen de buffers leeg en wacht er niets. Als de andere kant stopt met lezen, loopt eerst zijn ontvangstbuffer vol, dan jouw verzendbuffer daarachter, en pas dan heeft een send geen plek meer voor de volgende bytes. Vanaf dat moment wacht de send totdat de andere kant weer leest. Een ontvanger die het niet bijhoudt en zijn verzender op die manier afremt, heet backpressure.
Het programma van een kijker stopt met lezen. Wanneer begint de send van de server naar die kijker te wachten?
Probeer het met een echte client
De projectbestanden bevatten pl_ws.py, een programma dat voor deze cursus is geschreven en elke client speelt, en dat je in het vorige hoofdstuk draaide. Het scenario stalled-reader start je server, verbindt kijker
python pl_ws.py stalled-reader
Een run op de site drukte af:
scenario stalled-reader: viewer R completes its handshake and then never reads again
server options: the library's defaults with close_timeout=1.0 (open_server is not written yet)
viewer R is registered and reads nothing from now on
the scorekeeper got 10 replies out of 10
the server finished 11 sends to R, which read none of them; R was still registered: True
the kernel's buffers between the server and R took every one of those snapshots
the server shut down
Elf sends, de snapshot bij binnenkomst en tien updates, en geen ervan wachtte. De tweede regel noemt open_server, die les 4 schrijft; tot dan gebruikt het programma de eigen instellingen van de bibliotheek. Op een lokale computer hield een loopbackverbinding ongeveer 550 KB vast voordat een send moest wachten: de bibliotheek stuurde 6.325 snapshots naar een client die er geen enkele van las, voordat haar send eindelijk wachtte.
Waarom vertraagt slow-viewer een kijker met opzet in plaats van een echte client te gebruiken die stopt met lezen?
Een met opzet vertraagde kijker
Op het internet vult een kijker op een zwakke telefoonverbinding die buffers snel, en daarna duren de sends naar hem zo lang als zijn netwerk nodig heeft. Om die kosten op één machine te laten zien, verbindt het scenario slow-viewer kijker A en kijker S, een kijker die dit programma met opzet vertraagt: elke send van je server naar S wacht 0,3 s voordat hij vertrekt. Daarna stuurt de scorebijhouder drie scores.
python pl_ws.py slow-viewer
Dezelfde run op de site drukte af:
scenario slow-viewer: viewer S is slowed down on purpose; every send from the server to S waits 0.3 s first
server options: the library's defaults with close_timeout=1.0 (open_server is not written yet)
viewer A joined; its first message was a snapshot with version 0
viewer S joined; its first message was a snapshot with version 0
the scorekeeper sent 1 point for Owls; its reply was a snapshot with version 1
the scorekeeper sent 2 points for Foxes; its reply was a snapshot with version 2
the scorekeeper sent 3 points for Herons; its reply was a snapshot with version 3
score 1: the reply came after the server finished sending version 1 to S
score 2: the reply came after the server finished sending version 2 to S
score 3: the reply came after the server finished sending version 3 to S
the server shut down
viewer A received versions [0, 1, 2, 3], then the server closed it with 1001
viewer S received versions [0, 1, 2, 3], then the server closed it with 1001
Elk antwoord kwam nadat de trage send naar S klaar was. Het transcript meldt volgorde, geen tijd, omdat de volgorde is wat je code bepaalt. De afbeelding tekent één score met de tijd van boven naar beneden: de thread van de scorebijhouder links, een kijker die probeert binnen te komen rechts. Let op hoe lang de lock van het bord vastgehouden blijft, en waar beide kanten op wachten.
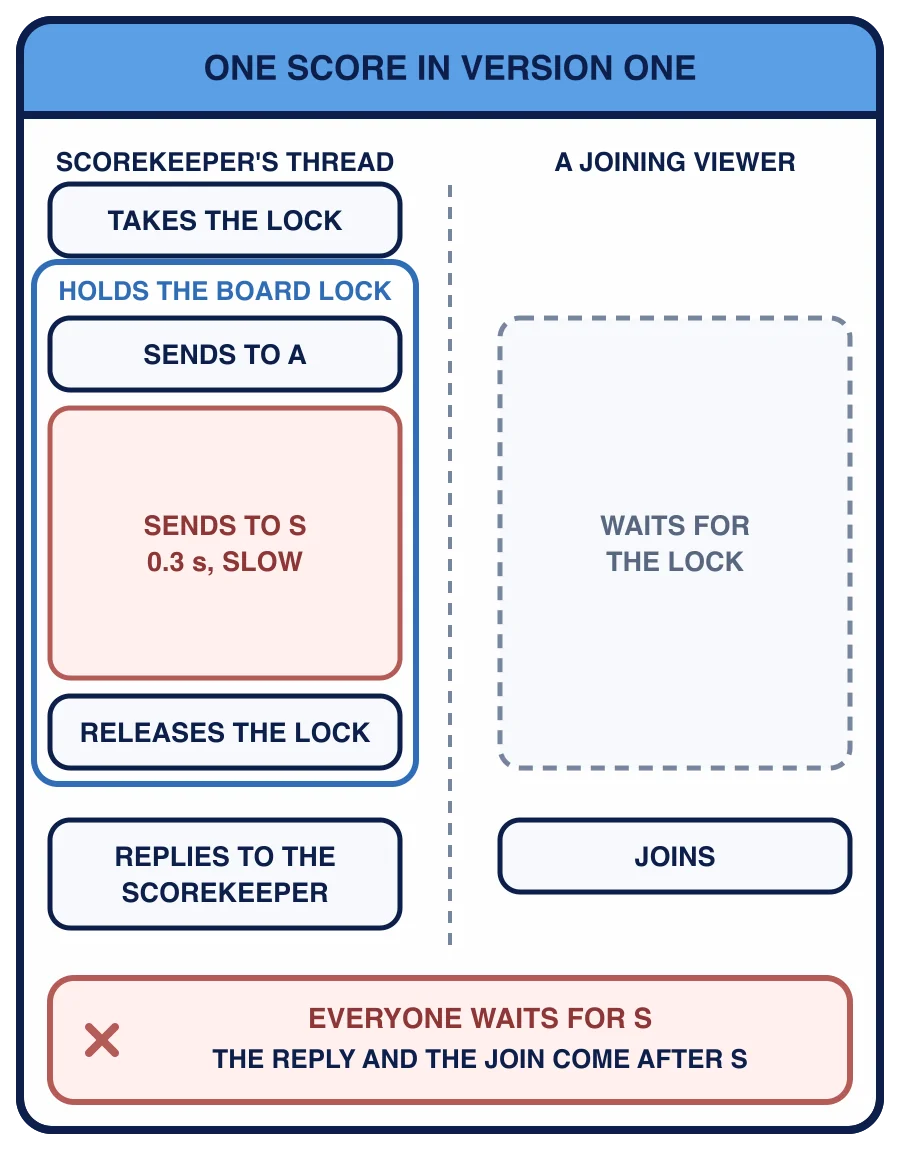
In woorden: de thread van de scorebijhouder neemt de lock van het bord, stuurt de update naar A, stuurt hem daarna naar S, wat 0,3 s duurt, en geeft pas dan de lock vrij en stuurt zijn antwoord. Een kijker die in die tijd probeert binnen te komen, wacht ook op de lock, en komt pas na het vrijgeven binnen.
Iedereen wacht op de traagste
Tel wie er voor S betaalt. De scorebijhouder, want zijn antwoord komt na de hele broadcast. Elke kijker die na S geregistreerd is, want de add_viewer heeft de lock nodig die de broadcast vasthoudt. Met duizend kijkers bepaalt de traagste het tempo voor allemaal, en een echte server kan niet kiezen welke clients verbinding met hem maken.
Met v1 duurt elke send naar S 0,3 s. Wie wacht er als de scorebijhouder scoort?
Wat het zou kunnen oplossen
Er zijn drie uitwegen. De server zou een kijker die traag is kunnen laten vallen, wat hard is voor een kijker die maar even achterloopt. Hij zou voor elke kijker een queue met elke update kunnen bijhouden en die sturen wanneer het kan, maar een kijker die nooit bijkomt, laat zijn queue zonder grens groeien. Of hij zou voor elke kijker alleen de nieuwste snapshot kunnen bewaren. Een snapshot bevat het hele bord, dus de nieuwste vervangt elke oudere, en een trage kijker die een versie overslaat, mist niets wat hij nodig heeft.
Waarom mag het scorebord een update voor een trage kijker overslaan?
Het scorebord kiest de derde weg. Les 2 bouwt voor één kijker een bakje dat één snapshot bevat, de nieuwste, en dat de thread wekt die hem zal sturen.