De OpenAI-client gebruiken
Wat de client verbergt
Les 1 bouwde elke client met max_retries=0 en beloofde een uitleg. Hier is die, als experiment dat je zelf kunt uitvoeren: hetzelfde mislukkende request via een client die meteen opgeeft en via een client die het opnieuw mag proberen.
Een dienst die twee keer faalt en dan werkt
Het gescripte model kan met opzet falen, een vast aantal keer. Met de requestheader X-Scripted-Scenario: server-error:2 krijgen de eerste twee requests met die header status 500, en elk request daarna krijgt het normale antwoord. Het gescripte model houdt die telling bij voor je sandbox, dus het derde request slaagt, welke client het ook verstuurt.
Een telling heeft een beginpunt nodig. De meegeleverde reset_scripted_model() verstuurt POST /v1/scripted/reset, wat de telling weer op nul zet. Zonder die reset zou python client_calls.py bij een tweede run een telling vinden die al voorbij twee is, en zouden de mislukkingen niet opnieuw gebeuren.
De demonstratie stuurt de header bij losse aanroepen mee met extra_headers:
failing = {"X-Scripted-Scenario": "server-error:2"}
messages = [{"role": "user", "content": "What is a Python list?"}]

reset_scripted_model()
client.chat.completions.create(model=MODEL, messages=messages, extra_headers=failing)

reset_scripted_model()
retrying = make_client().with_options(max_retries=2)
response = retrying.chat.completions.create(model=MODEL, messages=messages, extra_headers=failing)
extra_headers= voegt alleen aan die ene aanroep headers toe, anders dan de default_headers van scenario_client uit les 3, die een client bij elke aanroep meestuurt. De eerste aanroep gaat via de client uit je make_client(), met max_retries=0. De tweede gaat via een kopie daarvan, gemaakt met with_options(max_retries=2), wat de standaardinstelling van de client is. Elke aanroep wordt getimed met time.monotonic(), zoals in hoofdstuk 3.
Voer het uit
Voer python client_calls.py uit zodra je les 4 af hebt. Dit deel van de uitvoer is het experiment:
What the client hides:
With max_retries=0: InternalServerError after 0.0 seconds
With max_retries=2: an answer after 1.7 seconds:
A list is an ordered, changeable collection of values. You write one with square brackets, like [1, 2, 3], and you can add, remove and change items after creating it.
The study chat on the client:
You: What does len() return?
Run stopped at the next function to build: chat_turn is built in Lesson 6.
De tijden kunnen bij jou een paar tienden van een seconde afwijken, omdat de client zijn wachttijden een beetje varieert.
Wat er gebeurde bij de verborgen pogingen
Met max_retries=0 kreeg het eerste request zijn 500 en wierp de client meteen openai.InternalServerError op. Je code zag de mislukking.
Met max_retries=2 gebeurde met het eerste request hetzelfde, en zag je code niets. De client wachtte iets minder dan een halve seconde en verstuurde het request opnieuw. Ook de tweede poging kreeg een 500. De client wachtte iets minder dan een seconde en verstuurde het een derde keer, en die slaagde. Pas toen gaf create het antwoord terug. Er bereikten drie requests de dienst; je code deed één aanroep en kreeg één antwoord, en het enige wat je van de andere twee merkt, is de tijd die het kostte.
De afbeelding zet de twee runs onder elkaar. Alles binnen de haak gebeurde binnen één aanroep van create.
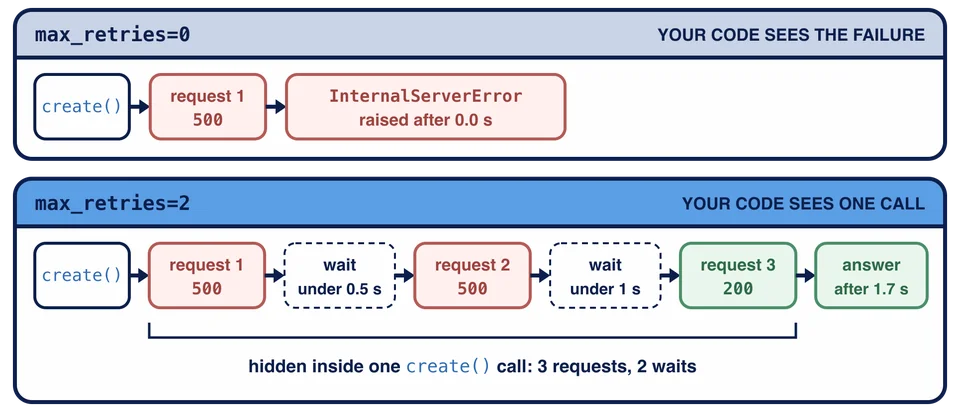
De client probeert het zelf opnieuw (retry) als een request mislukt op een manier die vanzelf kan overgaan: de verbinding mislukt of krijgt een time-out, of de dienst antwoordt met een status zoals 429 (te veel requests) of 500 en hoger. Voor elke nieuwe poging wacht hij iets langer. Met de standaardinstelling kan één aanroep in je code drie requests worden.
Waarom deze cursus het uitzet
Verborgen nieuwe pogingen zijn handig, en voor veel programma’s de juiste keuze. Voor een programma dat een taalmodel aanroept, verbergen ze dingen die je moet zien.
Kosten. Voor elk request dat een model bereikt, betaal je, op basis van de tokens die het model leest en schrijft. Een nieuwe poging na een time-out kan bijvoorbeeld betalen voor een heel antwoord dat nooit aankwam. Als de client zelf opnieuw probeert, kan je code die requests niet tellen.
Budgetten en tijd. Hoofdstuk 9 geeft de studieassistent een budget voor tokens en tijd. Een budget werkt alleen als de code die het bijhoudt elk request en elke wachttijd ziet. Meer dan een seconde wachten binnen één aanroep is voor die code onzichtbaar.
Tests. Een controle die één mislukking ensceneert, verwacht één aanroep. Met verborgen nieuwe pogingen kan dezelfde aanroep slagen, mislukken of seconden duren, afhankelijk van een instelling die de test nooit ziet.
Beslissen wat een nieuwe poging waard is. Een 500 kan vanzelf overgaan; een request dat de dienst als misvormd afwijst, nooit, en een weigering is het antwoord van het model, geen mislukking. Hoofdstuk 9 verdeelt mislukkingen in die een nieuwe poging waard zijn en die dat niet zijn, en probeert alleen de eerste soort opnieuw, met wachttijden die je code kiest en kan tellen.
Daarom wordt elke client in deze cursus gebouwd met max_retries=0, en bereiken mislukkingen je code. Hoofdstuk 9 voegt de nieuwe pogingen weer toe, op een plek waar je ze kunt zien.
Met max_retries=2 en het scenario server-error:2 gaf create na ongeveer 1.7 seconde een antwoord terug. Wat gebeurde er in die tijd?
Hoofdstuk 9 voegt een budget toe dat elk request en elke wachttijd telt. Waarom zijn daarvoor clients nodig die gebouwd zijn met max_retries=0?
De demonstratie roept reset_scripted_model() aan vóór elk van de twee aanroepen die server-error:2 gebruiken. Wat zou er zonder die aanroepen veranderen?