LLM-code testen · oefening
Bouw een kleine evalset
Je tests zeggen nu of de code klopt: die bouwt de juiste requests, handelt elk soort antwoord af en houdt zich aan zijn beloftes voor elk antwoord. Ze kunnen niet zeggen of de antwoorden goed zijn. Zijn K = 3 passages genoeg? Is MIN_SCORE = 2 te streng? Is het systeembericht duidelijk? Elk daarvan is een wijziging die je zou kunnen maken, en één antwoord ervoor en één erna kan je niet vertellen of die hielp.
Een eval kan dat wel. Dat is een vaste set vragen, elk met wat een goed resultaat moet bevatten, die door het programma gaat en wordt gescoord als slagingspercentage. Verander de prompt, voer de eval opnieuw uit en vergelijk de getallen.
De tien cases
EVAL_CASES in evals.py bevat tien vragen over de notities, elk met de notitie waar een goed antwoord uit komt:
{"question": "How do I make an independent copy of a list?", "note_id": "03-lists"}
De cases worden meegeleverd en niet door jou geschreven, omdat het gescripte model alleen vragen kan beantwoorden waarvoor het rijen heeft. Elke vraag gaat over een andere notitie, van strings tot modules tot testen.
Een case beantwoorden
answer_case(question, notes, *, client, k, system, budget), ook meegeleverd, beantwoordt één vraag. Lees hem in evals.py: het is answer_from_notes uit hoofdstuk 8 met twee wijzigingen. Het systeembericht is het argument system in plaats van altijd GROUNDED_SYSTEM, zodat les 7 een ander kan proberen. En de aanroep gaat via call_model uit hoofdstuk 9, met MAX_ATTEMPTS, time.sleep en het budget dat hij krijgt, zodat een live run een rate limit uitzit en de tokens van elk antwoord worden geteld. Net als answer_from_notes geeft hij geen antwoord zonder het model iets te vragen als de beste passage lager scoort dan MIN_SCORE, en geeft hij een ValueError als het antwoord niet geldig is of verwijst naar een passage die niet werd meegestuurd.
Twee scores
Een case kan op twee plekken misgaan, dus de eval geeft elk van die plekken een score:
Ophalen (retrieval): zat er tussen de passages die voor de vraag werden gekozen een passage uit de juiste notitie? Zo niet, dan heeft het model het antwoord nooit gezien.
Bronvermeldingen: verwees het antwoord naar een passage uit de juiste notitie? Daarvoor moet het ophalen die passage hebben gevonden, en moet het model die daarna hebben gebruikt en correct hebben vermeld.
Het ophalen kan de notitie vinden terwijl het antwoord toch mislukt, en een antwoord kan mislukken terwijl het ophalen goed ging. Met één score zou je niet kunnen zien welk deel je moet repareren.
Bouw de drie functies
Schrijf in evals.py:
retrieval_hit(case, chunks): geefTrueterug als denote_idvan een van de fragmenten inchunksgelijk is aancase["note_id"], en andersFalse.citation_hit(case, answer): geefTrueterug als een bronvermelding inanswer.citationsbegint metcase["note_id"]gevolgd door#, en andersFalse. Controleer opcase["note_id"] + "#", niet op het kale id, zodat een case over03-listniet overeenkomt met03-lists#4.run_eval(cases, notes, *, client, k, system):begin met
budget = {"limit": EVAL_BUDGET, "used": 0}enresult = {"cases": len(cases), "retrieval": 0, "citations": 0, "misses": [], "tokens": 0};neem voor elke case de vraag, zoek
best_chunks(question, note_chunks(notes), k)en roep daaropretrieval_hitaan;roep daarna binnen
tryanswer_case(question, notes, client=client, k=k, system=system, budget=budget)aan, encitation_hitop het antwoord. Bijexcept ValueError:is het antwoord afgewezen, en dat telt als een gemiste bronvermelding;tel één op bij
result["retrieval"]en bijresult["citations"]voor elke controle die raak was, en voeg de vraag toe aanresult["misses"]als een van beide miste;zet na de lus
result["tokens"]opbudget["used"]en geefresultterug.
Vang alleen ValueError af. Een aanroep die mislukte met een 500, of een run die zijn budget bereikte, zegt niets over de kwaliteit van de antwoorden, dus die fouten gaan door naar boven en stoppen de eval.
Voer de eval uit
Voer python evals.py uit. Na de opname uit les 4 voert de demonstratie jouw run_eval uit over EVAL_CASES met GROUNDED_SYSTEM en K, en drukt het resultaat af met de meegeleverde print_eval:
The eval with GROUNDED_SYSTEM:
GROUNDED_SYSTEM: retrieval 9 of 10, citations 7 of 10, 3148 tokens
  missed: Why should a default argument never be a list?
  missed: How does pytest find my tests?
  missed: How do I filter items with a list comprehension?
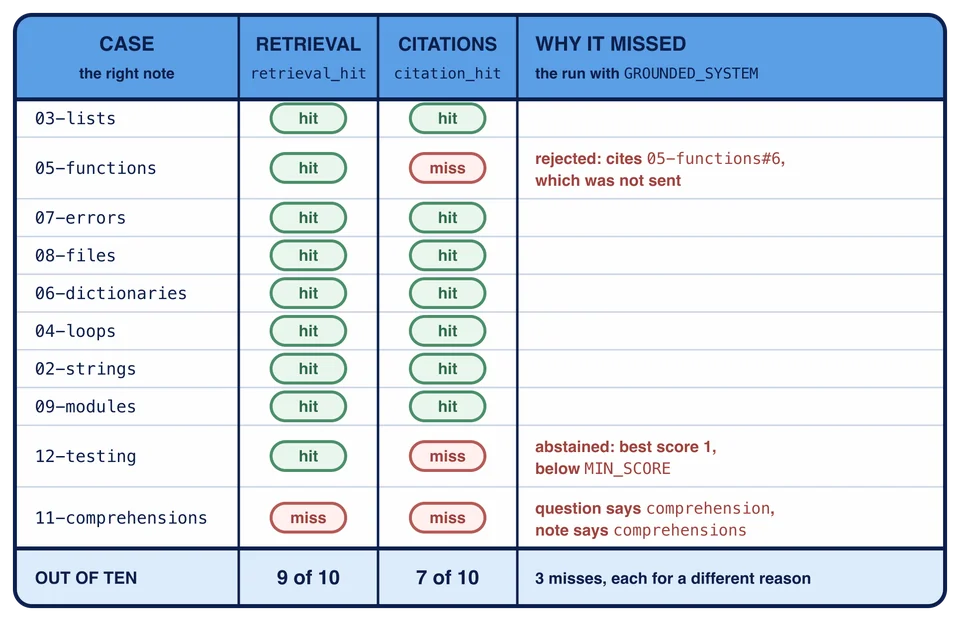
Daarna volgt een vergelijking van twee systeemberichten; die hoort bij les 7. Negen van de tien voor ophalen, zeven van de tien voor bronvermeldingen, en drie missers, elk om een andere reden:
Why should a default argument never be a list? Het ophalen vond de notitie over functies, maar het antwoord verwijst naar
05-functions#5en05-functions#6, en de tweede zat niet bij de drie verstuurde passages (05-functions#5,01-variables#2en05-functions#4).parse_cited_answerwijst het af, dus het is een gemiste bronvermelding. Dit is ook het antwoord dat hoofdstuk 8 afwees.How does pytest find my tests? De beste passage scoort maar 1, onder
MIN_SCORE, dusanswer_casegeeft geen antwoord en vraagt niets. De notitie over testen zat bij de drie passages, op de tweede plaats, dus het ophalen telt als raak, maar “I don’t know” verwijst nergens naar.How do I filter items with a list comprehension? Het ophalen miste: de vraag zegt
comprehension, de notitie zegtcomprehensions, en de woordvergelijking uit hoofdstuk 8 behandelt die als verschillende woorden. Het model kreeg passages uit de notities over lijsten en lussen, zei dat die de vraag niet beantwoorden, en verwees nergens naar. Beide scores missen.
De eval deed 9 requests, omdat de pytest-case niets vroeg, en die gebruikten samen 3148 tokens.
De tabel zet de twee scores naast elkaar voor alle tien cases. Lees een kolom van boven naar beneden voor het totaal, en lees de drie rijen met een misser van links naar rechts: elk mislukte op een andere plek.
Voeg een eigen case toe
Je kunt een case toevoegen aan EVAL_CASES en de eval opnieuw uitvoeren. Het ophalen wordt voor elke vraag op dezelfde manier gescoord, dus een nieuwe case laat je zien wat de woordvergelijking vindt. Het gescripte model heeft echter alleen antwoorden voor deze tien. Op elke andere vraag stuurt het zijn echo, en die is geen JSON, dus het antwoord wordt afgewezen en de case scoort een gemiste bronvermelding. Dat zegt iets over het gescripte model, niet over je vraag. Bij het controleren van je werk worden eigen cases gebruikt, dus een case die je toevoegt, verandert daar niets.
Hoe je werk wordt gecontroleerd
De controles gebruiken onbekende notities en cases en de nep-client, met de meegeleverde answer_case geïnstalleerd door de controle (met een sleep die alleen vastlegt). Ze controleren retrieval_hit en citation_hit op bijna-treffers en lege lijsten; en bij run_eval de tellingen, de missers in de volgorde van de cases, de tokens, dat een case zonder antwoord geen request doet, dat een afgewezen antwoord als misser telt zonder de eval te stoppen, dat een 500 bij elke poging doorgaat naar boven, dat elke run met een nieuw budget uit EVAL_BUDGET begint, en dat k en system in de requests terechtkomen.
De case How do I filter items with a list comprehension? mist bij het ophalen en bij de bronvermeldingen. Waar moet je eerst naar kijken?
Waarom vangt run_eval rond answer_case alleen ValueError af?
Opdracht
Schrijf in evals.py:
retrieval_hit(case, chunks):Trueals denote_idvan een van de fragmenten gelijk is aancase["note_id"].citation_hit(case, answer):Trueals een bronvermelding inanswer.citationsbegint metcase["note_id"] + "#".run_eval(cases, notes, *, client, k, system): begin metbudget = {"limit": EVAL_BUDGET, "used": 0}enresult = {"cases": len(cases), "retrieval": 0, "citations": 0, "misses": [], "tokens": 0}. Score voor elke caseretrieval_hitopbest_chunks(question, note_chunks(notes), k); roep daarna binnentryanswer_case(question, notes, client=client, k=k, system=system, budget=budget)aan en scorecitation_hit, waarbij eenValueErrorals misser telt. Tel elke treffer, voeg de vraag toe aanmissesals een van beide controles miste, zet aan het eindresult["tokens"] = budget["used"]en geefresultterug. Vang niets anders af danValueError.
Voer python evals.py uit om de scores van de eval te zien en controleer daarna je werk.