Mee naar huis
Stel een uitgavenlimiet in voordat je begint
Op het cursusmodel kost een fout niets. Een lus die nooit stopt, een programma dat te vaak opnieuw probeert of een prompt die bij elke beurt groeit, verspilt alleen wat tijd. Bij een echte aanbieder wordt elk van die fouten gefactureerd. Bepaal voordat het programma zijn eerste betaalde aanroep doet hoeveel het mag uitgeven, en zet een limiet op elk niveau waar iets mis kan gaan.
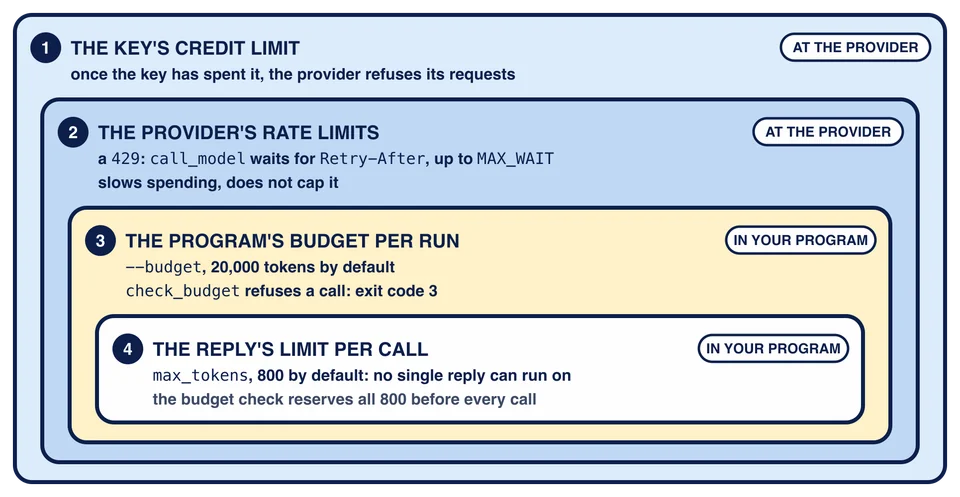
Vier limieten, van buiten naar binnen
De kredietlimiet van de sleutel
De buitenste limiet zit bij de aanbieder. Bij OpenRouter kun je elke sleutel een eigen kredietlimiet geven: zodra de sleutel zoveel heeft uitgegeven, weigert de aanbieder zijn requests. Stel die in vóór de eerste aanroep, op een klein bedrag dat je zonder pijn kwijt zou kunnen.
Dit is de limiet die nog steeds geldt als al het andere fout is: een bug in je lus, een budget dat je te hoog hebt ingesteld, een sleutel die is uitgelekt en door iemand anders wordt gebruikt. Niets in je code kan hem uitschakelen, omdat hij niet in je code zit. Het eigen live model van de cursus werkt op dezelfde manier: de sleutel ervan heeft een eigen kredietlimiet, als vangnet achter de limieten die de dienst instelt.
De rate limits van de aanbieder
Aanbieders beperken ook hoeveel requests je per minuut stuurt, en soms per dag. Ga je over zo’n limiet, dan krijg je een 429. Je programma handelt dat al af: call_model uit hoofdstuk 9 wacht de tijd uit de Retry-After-header af en probeert het opnieuw, tot MAX_WAIT (60 seconden), en geeft het op met exitcode 1 wanneer de aanbieder om een langere wachttijd vraagt. Een rate limit beschermt de aanbieder en remt je uitgaven af, maar begrenst ze niet.
Het live model van de cursus is een voorbeeld van limieten die een dienst voor zijn gebruikers instelt: tien requests per minuut, een dagelijks aantal requests en tokens, en een dagelijks kostenplafond. Hoofdstuk 9 kwam de eerste twee tegen als 429-antwoorden met een korte en een lange Retry-After.
Het budget van het programma per run
--budget is de eigen limiet van de studieassistent, 20000 tokens per run tenzij je een ander getal meegeeft. Elke modelaanroep van de run put uit dat ene budget, en check_budget uit hoofdstuk 9 weigert een aanroep voordat hij wordt verstuurd als de schatting niet past in wat er over is. Een geweigerde aanroep beëindigt de run met exitcode 3.
De limiet op het antwoord per aanroep
Elke aanroep stuurt max_tokens mee, DEFAULT_MAX_TOKENS (800) tenzij het request iets anders zegt, zodat geen enkel antwoord eindeloos kan doorlopen. De budgetcontrole reserveert dat hele aantal vóór elke aanroep, omdat het antwoord zo lang zou kunnen zijn. Daarom kan een run worden geweigerd terwijl er ruim genoeg plaats is voor het antwoord dat hij werkelijk zou hebben gekregen: de controle moet kloppen voor het langste antwoord dat het request toestaat, en kan niet van tevoren weten dat dit antwoord kort zou zijn.
De afbeelding nest de vier limieten. Elke limiet werkt binnen de limieten eromheen, en alleen de buitenste twee liggen buiten je code. Daarom geldt de kredietlimiet van de sleutel nog steeds als je programma fout zit.
Wat een run kost
Hoofdstuk 10, les 1 liet een live antwoord zien van openai/gpt-oss-20b dat 72 invoertokens en 206 uitvoertokens gebruikte. OpenRouter meldde als kosten $0.0000310. Bij de catalogusprijzen van het model op 2026-11-08, $0.03 per miljoen invoertokens en $0.13 per miljoen uitvoertokens, zou het $0.0000289 hebben gekost. Het verschil zegt dat het endpoint dat antwoordde ongeveer $0.14 per miljoen uitvoertokens rekende. OpenRouter stuurt een request naar een van meerdere endpoints voor een model, en die rekenen niet allemaal hetzelfde.
Met de prijs die werkelijk werd gerekend, zou een hele run die zijn volledige standaardbudget gebruikt ongeveer dit kosten:
20,000 × $0.14 / 1,000,000 = $0.0028
Dat is ongeveer $0.003 per run, afhankelijk van het endpoint dat OpenRouter kiest. Het telt elk token tegen de uitvoerprijs, de hoogste van de twee, dus het zit eerder te hoog dan te laag. Toch blijft het een schatting, geen harde grens. Het budget telt tekens gedeeld door vier, wat dicht bij de telling van de aanbieder ligt maar er niet precies mee overeenkomt, en het laat de toolbeschrijvingen weg die ask bij elke agentstap meestuurt en die de aanbieder wel telt. Een live run kan iets boven --budget uitkomen.
De meeste runs gebruiken veel minder: ask uit hoofdstuk 11 gebruikte 539 tokens op het cursusmodel. Maar de prijs hangt af van het model. Een ander model kan per token honderd keer zoveel kosten, dus lees de prijs van de aanbieder voor een model voordat je het programma erop richt.
Getallen om thuis opnieuw te bekijken
De cursus koos zijn getallen voor het cursusmodel, dat ruim binnen een seconde antwoordt en tokens telt met een eenvoudige regel. Zodra het project van jou is, zijn dit de instellingen om opnieuw te bekijken, allemaal in je eigen bestanden:
CLIENT_TIMEOUTinclient_calls.py, 10 seconden. Een tragere aanbieder of een groter model heeft misschien meer tijd nodig; hoofdstuk 9 liet zien hoe een time-out eruitziet.DEFAULT_MAX_TOKENSinreliable.py, 800. Een redeneermodel besteedt een deel van zijnmax_tokensaan nadenken voordat het het antwoord schrijft, dus een lang antwoord kan worden afgekapt waar dat bij het cursusmodel nooit gebeurde.MAX_WAITinreliable.py, 60 seconden: de langste wachttijd bij een rate limit voordat het programma het opgeeft.--budgetop de, standaard 20000 tokens.
Verander er één tegelijk, en bekijk het log van je runs ervoor en erna. Les 4 voegt dat log toe.
Je agent heeft een bug: hij blijft om tools vragen, en een wijziging die je per ongeluk hebt gemaakt, heeft --budget op 10000000 gezet. Welke limiet stopt de uitgaven nog steeds?
Wat kost één run op openai/gpt-oss-20b ongeveer als hij zijn hele standaardbudget gebruikt, en waarom is het bedrag niet exact?
Een run heeft nog 700 tokens budget over. De tekst van de volgende aanroep is ongeveer 100 tokens en het echte antwoord zou 50 tokens zijn geweest. Waarom weigert de budgetcontrole de aanroep?