Hoofdstuk 11
Eindproject
De opdracht voor het eindproject
Je hebt elk onderdeel van de studieassistent gebouwd. Hij beantwoordt vragen uit de notities met een agent en een zoektool, schrijft quizzen, streamt een chat, overleeft rate limits en afgebroken streams, blijft binnen een tokenbudget en heeft tests die geen netwerk nodig hebben. Maar er is nog steeds geen programma dat iemand kan uitvoeren. Elk onderdeel is een functie die door een andere functie wordt aangeroepen.
In dit hoofdstuk voeg je de onderdelen samen tot één opdrachtregelprogramma, study_assistant.py, in stappen die elk gecontroleerd worden. Deze les is de opdracht: wat het afgeronde programma moet doen, welke delen je krijgt en hoe het gecontroleerd wordt.
Je project voor dit hoofdstuk
Open study_assistant.py in de projecteditor. Dit is het programma dat je in dit hoofdstuk afmaakt. Bovenaan importeert het wat het nodig heeft uit de cursusbestanden die je eerder hebt gebouwd, en daarna stelt het zeven namen in:
BASE_URL = "http://llm-api:8080/v1"
MODEL = "pl-scripted"
API_KEY_ENV = "STUDY_ASSISTANT_API_KEY"
NOTES_DIR = Path("notes")

DEFAULT_BUDGET = 20000
ASK_TOOLS = {"search_notes": search_notes, "read_note": read_note}
ASK_MAX_STEPS = 6
Daaronder staan vijf functies met afgeronde code die je in deze les leest: positive_int, question_count, build_parser, use_settings en build_client. De andere tien zijn nog niet af. Die bouw je in les 2 tot en met 6, en in les 6 sluit je het bestand af met de regel die het programma uitvoert.
De andere bestanden krijg je. reliable.py is het aanroepbeleid uit hoofdstuk 9, met één wijziging die je in les 4 tegenkomt, en alles wat het importeert staat er weer naast. evals.py en de map tests zijn de afgeronde eval en tests uit hoofdstuk 10. fakes.py is de nep-client (fake). stages.py is de demonstratie van dit hoofdstuk, die je in de Shell uitvoert met python stages.py: die roept elke stap van study_assistant.py aan zodra die bestaat, net als de demonstraties in de eerdere hoofdstukken. De controle van je werk gebruikt eigen kopieën van al deze bestanden, dus een wijziging daarin kan geen beoordeling veranderen, maar wel stages.py laten vastlopen.
De opdracht
Het afgeronde programma heeft drie commando’s, die je in de python study_assistant.py:
$ python study_assistant.py ask "How do I make an independent copy of a list?"
Use scores.copy() or list(scores). Both build a new list, so a change made through one name no longer shows through the other.

Sources: 03-lists#4
$ python study_assistant.py quiz 03-lists --count 2
$ python study_assistant.py chat
ask QUESTIONvoert de agent uit met twee tools,search_notesenread_note, en drukt het antwoord af, een lege regel en naSources:de labels van de passages die gebruikt zijn. Een antwoord mag alleen een passage vermelden die een zoekopdracht in dezelfde run heeft teruggegeven. Als het eerste antwoord die regel breekt of geen geldige JSON is, vertelt het programma het model wat er mis was en vraagt het nog één keer. Een antwoord zonder bronvermeldingen mag, en druktSources: noneaf.quiz NOTE_IDschrijft een meerkeuzequiz over één notitie, met--count Nvragen, van 1 tot 5. De standaardwaarde is 3.chatleest per regel één vraag die je typt, streamt elk antwoord en houdt het gesprek gaande tot je een lege regel typt.
--budget TOKENS, geschreven vóór het commando, stelt in hoeveel tokens één run maximaal mag gebruiken. De standaardwaarde is 20000, en elke modelaanroep in de run put uit dat ene budget, ook de tweede poging van ask.
De afbeelding laat zien hoe het programma in elkaar zit en welke les elk deel bouwt. main voert één commando uit, elk commando is gebouwd uit functies die je in eerdere hoofdstukken hebt geschreven, en elke modelaanroep gaat via het aanroepbeleid uit hoofdstuk 9, op het ene budget van de run.
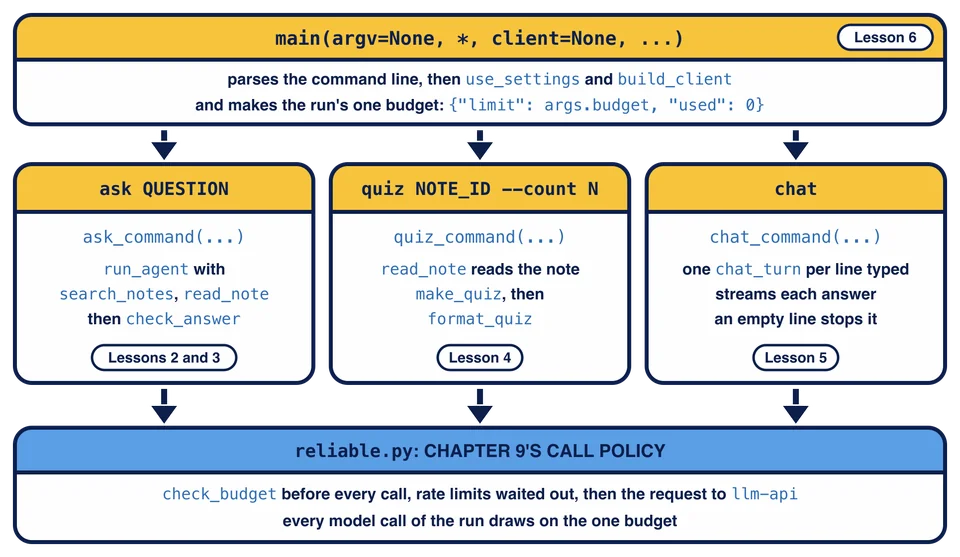
Het programma schrijft naar twee streams, zoals de programma’s in Python in de praktijk. Antwoorden, quizzen en de chat gaan naar de standaarduitvoer (standard output). Als er iets misgaat, schrijft het programma één regel naar de standaardfout (standard error): Error: gevolgd door een korte beschrijving van wat er misging. ask en quiz drukken dan niets af op de standaarduitvoer; chat laat staan wat al afgedrukt was, ook het begin van een antwoord dat afbrak. Daarna eindigt het programma met een exitcode die zegt wat voor fout het was:
| Code | Betekenis | Voorbeelden |
|---|---|---|
0 | het werkte | een antwoord, een quiz, een afgeronde chat |
1 | de run mislukte | de agent stopte zonder antwoord, een antwoord dat na de nieuwe poging nog ongeldig was, een antwoord afgekapt bij max_tokens, een afgebroken stream, een modelfout die nieuwe pogingen niet oplosten |
2 | de | een ontbrekende vraag, --count 9 |
3 | het budget was op | --budget 1000 voor een vraag die meer nodig heeft |
4 | de notitie bestaat niet | quiz 99-magic |
In de terminal toont echo $? direct na een commando de code waarmee het laatste commando eindigde.
Het startpunt is één functie:
def main(argv=None, *, client=None, notes_dir=NOTES_DIR, stdin=None, sleep=time.sleep):
Die verwerkt argv, voert het commando uit en geeft de exitcode terug. Als je hem zonder argumenten aanroept, zoals het programma doet wanneer je het uitvoert, leest hij de echte opdrachtregel, bouwt hij de echte client, leest hij je toetsenbord en wacht hij echt. Met de keywordargumenten kan een test elk daarvan vervangen.
Commando’s met eigen argumenten
In Python in de praktijk heb je parsers gebouwd met positionele argumenten en opties. Dit programma heeft nog één ding nodig. Het eerste woord na de opties is de naam van een commando, een woord dat zegt welke taak er gedaan moet worden, en elk commando heeft eigen argumenten: ask krijgt een vraag, quiz krijgt een notitie-id en --count, en chat krijgt niets. argparse noemt dit subcommando’s (subcommands). Hier is de meegeleverde build_parser, ingekort tot de delen die ertoe doen:
parser = argparse.ArgumentParser(prog="study_assistant.py", description="...", allow_abbrev=False)
parser.add_argument("--budget", type=positive_int, default=DEFAULT_BUDGET, metavar="TOKENS", help="...")
commands = parser.add_subparsers(dest="command", required=True, metavar="COMMAND")
ask = commands.add_parser("ask", help="...", allow_abbrev=False)
ask.add_argument("question", metavar="QUESTION", help="the question, in quotes")
quiz = commands.add_parser("quiz", help="...", allow_abbrev=False)
quiz.add_argument("note_id", metavar="NOTE_ID", help="the id of a note, such as 03-lists")
quiz.add_argument("--count", type=question_count, default=3, metavar="N", help="...")
commands.add_parser("chat", help="...", allow_abbrev=False)
add_subparsers geeft een object terug waarvan de methode add_parser één commando toevoegt en daar een parser voor teruggeeft, dus ask.add_argument(...) geeft dat commando eigen argumenten. dest="command" zegt waar het verwerkte resultaat de naam van het commando bewaart: na ask "What is a tuple?" is args.command gelijk aan "ask" en args.question gelijk aan "What is a tuple?". Na quiz 03-lists is args.command gelijk aan "quiz", args.note_id gelijk aan "03-lists" en args.count gelijk aan 3. Door required=True is een ontbrekend commando een gebruiksfout. --budget hoort bij de bovenste parser en staat dus vóór het commando.
allow_abbrev=False zorgt dat argparse geen ingekorte optie accepteert, zoals --cou voor --count. De parser van elk commando heeft dit ook nodig, want de parser van een subcommando neemt die instelling niet over van de bovenste. prog="study_assistant.py" legt de programmanaam in de gebruiksregel vast, welk bestand het programma ook start.
positive_int en question_count volgen het patroon uit Python in de praktijk voor het type van een optie: elk zet de tekst om met int binnen try, en werpt argparse.ArgumentTypeError op met een korte regel voor een woord dat geen getal is of een getal buiten het bereik. argparse drukt die regel af na de naam van de optie, toont de gebruiksregel op de standaardfout en beëindigt het programma met code 2, voordat er iets van jouw code draait. Daar komt exitcode 2 vandaan: die schrijf je nooit zelf.
Zodra je in les 6 de regel hebt toegevoegd die main uitvoert, drukt --help dit af:
$ python study_assistant.py --help
usage: study_assistant.py [-h] [--budget TOKENS] COMMAND ...

Answer questions from the course notes, quiz yourself and chat.

positional arguments:
  COMMAND
    ask            answer a question from the notes, with sources
    quiz           write a multiple-choice quiz about one note
    chat           chat about Python, one question per line

options:
  -h, --help       show this help message and exit
  --budget TOKENS  the most tokens this run may use (default: 20000)
$ python study_assistant.py quiz --help
usage: study_assistant.py quiz [-h] [--count N] NOTE_ID

positional arguments:
  NOTE_ID     the id of a note, such as 03-lists

options:
  -h, --help  show this help message and exit
  --count N   how many questions, from 1 to 5 (default: 3)
Tot die tijd definieert het bestand alleen functies, dus als je het uitvoert, wordt er niets afgedrukt.
Instellingen die het programma zet
De cursusbestanden hebben elk hun eigen namen. Toen reliable.py from client_calls import MODEL uitvoerde, maakte Python een naam MODEL binnen reliable, en die lezen run_agent, make_quiz en chat_turn. read_note en note_ids lezen NOTES_DIR in tools.py, en search_notes leest NOTES_DIR in retrieval.py. Het programma heeft een eigen MODEL en een eigen notitiemap, dus het moet de namen zetten die deze functies lezen. De meegeleverde use_settings(notes_dir) doet dat, via elke module:
reliable.MODEL = MODEL
tools.NOTES_DIR = notes_dir
retrieval.NOTES_DIR = notes_dir
Daarom importeert study_assistant.py naast de functies die het gebruikt ook de modules zelf, met import reliable, import retrieval en import tools. Als je de naam in een module zo van buitenaf verandert, verlies je dat snel uit het oog, dus het programma doet het op één plek, aan het begin van main, en nergens anders.
build_client() geeft dezelfde client terug als make_client() uit hoofdstuk 5, gebouwd met de BASE_URL van dit bestand: OpenAI(base_url=BASE_URL, api_key="sandbox", timeout=CLIENT_TIMEOUT, max_retries=0). Het cursusmodel controleert geen sleutel. In hoofdstuk 12 wordt een echte sleutel gelezen uit de omgevingsvariabele die API_KEY_ENV noemt.
Hoe het gecontroleerd wordt
De controles voeren je programma uit zoals de tests in hoofdstuk 10 run_agent uitvoerden: ze roepen main aan met een lijst argumenten, een FakeClient met gescripte antwoorden, een tijdelijke notitiemap met notities die je nog nooit hebt gezien, getypte invoer uit io.StringIO en een sleep die alleen bijhoudt hoe lang er gewacht zou worden. Daarna kijken ze naar de exitcode, de standaarduitvoer en de standaardfout. Niets bereikt llm-api, en er wordt nergens echt gewacht. Daarvoor zijn de keywordargumenten van main.
Les 2 tot en met 6 bouwen elk één stap en worden gecontroleerd met de eigen versies van de eerdere stappen uit de controle, zodat een fout wordt gemeld in de les waarin hij gemaakt is. Les 7 controleert het hele programma zonder iets van jou te vervangen. Les 8 voert de eval uit hoofdstuk 10 uit met de definitieve instellingen.
Voer het uit
Voer in de Shell python stages.py uit. Het begint met het blok van les 2. Het voert de agent uit met de instellingen van ask op de kopieervraag via het cursusmodel, drukt de trace af met print_trace uit hoofdstuk 7 en stopt bij de eerste functie die je nog niet hebt gebouwd:
Lesson 2: the agent's run for the copy question
Step 1 (159 tokens)
  search_notes {"query": "independent copy of a list"} -> 763 characters
Step 2 (380 tokens)
  answered
Run stopped at the next function to build: trace_labels is built in Lesson 2.
Wat bevat args.command na python study_assistant.py ask "What is a tuple?"?
Met welke exitcode eindigt python study_assistant.py quiz 03-lists --count 9, en waar komt die vandaan?
Waarom krijgt main een argument client in plaats van altijd build_client() aan te roepen?