Wo Python seine Stärken hat
KI-Modelle trainieren und nutzen
Ein Supportteam versinkt in Nachrichten. Einige betreffen Rechnungen, andere Lieferungen, wieder andere den Zugang zu einem Konto. Das Team möchte Software, die für jede neue Nachricht beim Eingang ein Thema vorschlägt.
Das ist eine sinnvolle Aufgabe für KI und zeigt gut, dass „KI nutzen“ eigentlich eine Folge von Entscheidungen bedeutet, die meistens Menschen treffen.
Was ein Modell eigentlich ist
Ein KI-Modell ist ein System, das Muster aus Beispielen gelernt hat und für etwas, das es noch nie gesehen hat, eine Vorhersage oder ein erzeugtes Ergebnis liefern kann.
Hier wären die Beispiele alte Nachrichten, denen bereits Themen wie Rechnung oder Lieferung zugeordnet wurden. Das Modell lernt Muster in diesen Zuordnungen und schlägt anschließend für eine neue Nachricht ein Thema vor.
Dieser Vorschlag ist keine Tatsache. Das Modell kann eine Nachricht falsch verstehen, eine Verzerrung aus seinen Lernbeispielen zuverlässig übernehmen oder unbemerkt schlechter werden, wenn sich die echten Nachrichten verändern. Deshalb steht das Prüfen im Mittelpunkt dieses Ablaufs, nicht das Trainieren.
Der Ablauf und der Ort der Berechnungen
Das Diagramm beantwortet zwei Fragen gleichzeitig: In welcher Phase befindet sich das Team, und wo laufen die großen numerischen Berechnungen tatsächlich?
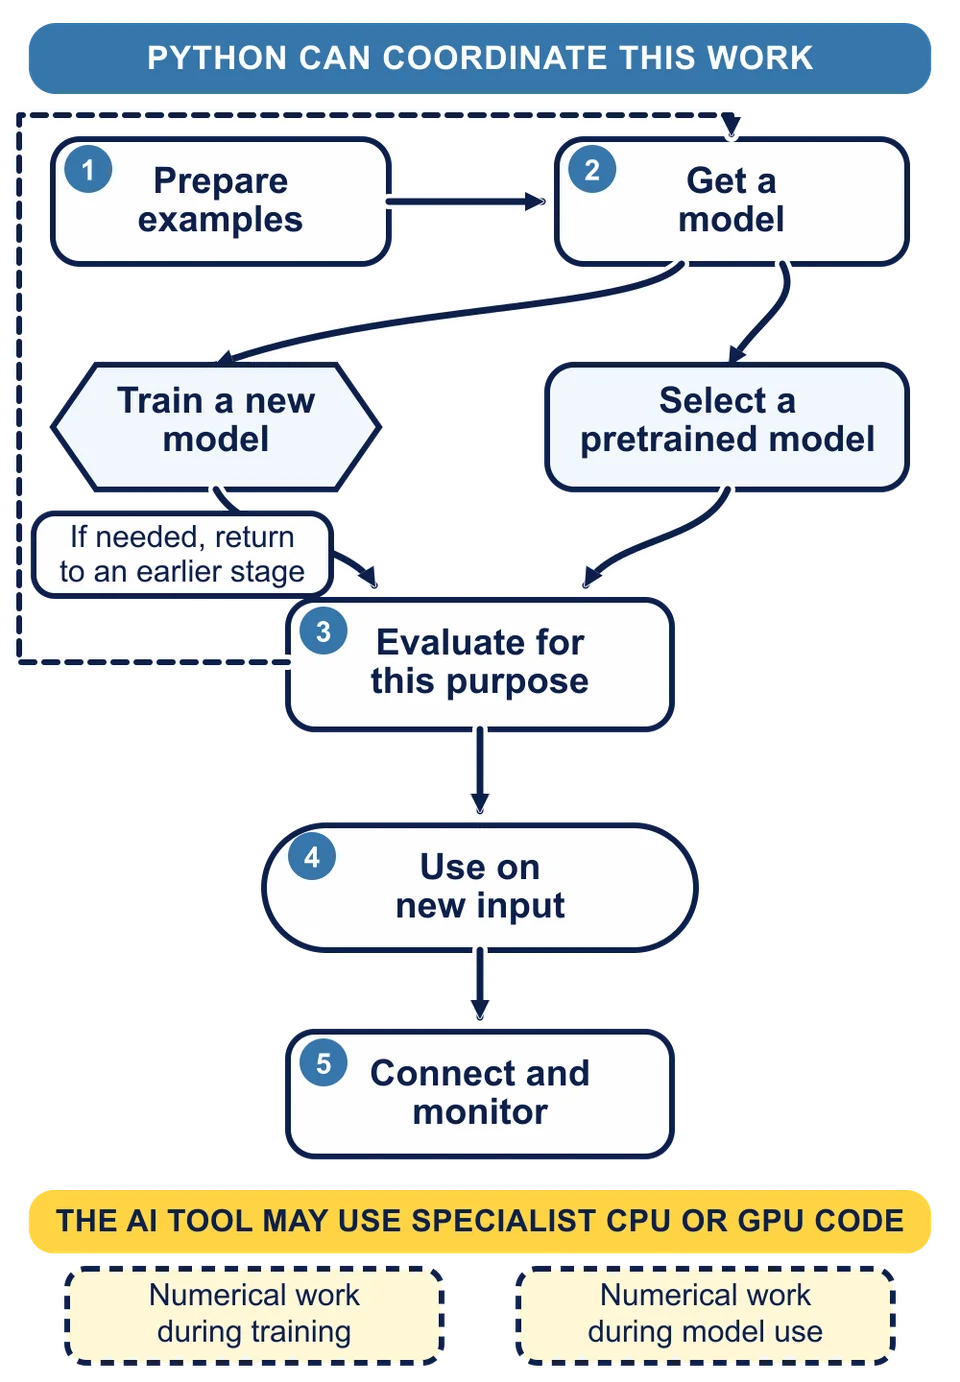
Es beginnt mit vorbereiteten Beispielen. Für diese Phase gilt alles aus der letzten Lektion. Ein leistungsfähiges Modell kann schlecht ausgewählte oder falsch verstandene Beispiele nicht reparieren. Jemand muss wissen, woher die Daten stammen und ob das Team sie verwenden darf.
Dann verzweigt sich der Weg. Das Team kann ein Modell trainieren, also es mithilfe von Beispielen so anpassen, dass es nützliche Muster erkennt. Ein großes Modell von Grund auf zu trainieren kann enorme Mengen an Daten, Fachwissen, Rechenzeit und Geld erfordern. Kleinere Modelle können deutlich weniger verlangen. Oder das Team nimmt ein vortrainiertes Modell, das jemand anderes bereits trainiert hat, und prüft es mit den eigenen Nachrichten. „Wir nutzen KI“ sagt nichts darüber aus, welcher Weg gewählt wurde oder ob das Team Anfragen an ein Modell schickt, das jemand anderes betreibt.
Beide Wege führen durch eine Bewertung, bevor etwas einen Kunden erreicht. Ein Modell zu evaluieren, also zu bewerten, bedeutet, sein Verhalten anhand geeigneter Daten zu prüfen, mit denen es nicht trainiert wurde. Eine einzelne Zahl reicht selten aus: Ein Modell kann häufige Lieferfragen gut und seltene Kontoprobleme schlecht behandeln oder in einer Sprache funktionieren und in einer anderen nicht. Was ein Fehler kostet, hängt völlig davon ab, was danach passiert.
Die Bewertung führt das Team häufig zurück. Dafür steht der Rückwärtspfeil. Echte KI-Arbeit ist kein einmaliger geradliniger Weg von links nach rechts.
Danach wird das Modell eingesetzt. Das heißt oft Inferenz und bedeutet einfach, es zu benutzen. Eine Nachricht geht hinein, ein Themenvorschlag kommt heraus, und eine Supportkraft bleibt beteiligt und kann ihn annehmen oder überstimmen. Anschließend beobachtet das Team, was im laufenden Betrieb passiert. Denn neue Arten von Nachrichten tauchen auf, Kosten verändern sich, und Fehler häufen sich oft bei einer bestimmten Gruppe von Menschen.
Das Band unten im Diagramm überrascht viele. In Werkzeugen wie PyTorch und TensorFlow läuft ein großer Teil der aufwendigen numerischen Arbeit in spezialisiertem Code auf einer CPU, dem Hauptprozessor eines Computers, oder einer GPU, einem Prozessor, der viele numerische Operationen gleichzeitig ausführen kann. Die genaue Aufteilung hängt vom Werkzeug und von der Operation ab.
Warum ist Python dann überall in der KI?
Das ist eine berechtigte Frage. Wenn gewöhnlicher Python-Code beim Rechnen nicht schnell ist, warum dominiert Python ein Gebiet, das auf Berechnungen aufbaut?
Weil Python die Berechnungen steuern kann, ohne jeden Schritt als gewöhnliche Python-Anweisung auszuführen. Es bereitet die Informationen vor, beschreibt die Arbeit, ruft das Framework auf, untersucht die Ergebnisse, bewertet das Verhalten und verbindet das Ergebnis mit einem Produkt. PyTorch und TensorFlow geben unterstützte rechenintensive Operationen an Code weiter, der auf Geschwindigkeit ausgelegt ist.
Python ist der Ort, an dem Menschen koordinieren, und Koordination macht den größten Teil der Arbeit aus. Deshalb ist Python für das Trainieren und Nutzen von KI gut geeignet. Der ehrliche Grund dafür ist nicht, dass Python selbst schnell ist. Die damit verbundenen Bibliotheken sind es aber!
Die Bibliothek trifft keine Entscheidungen
Ob die Daten geeignet sind, was die Hardware kostet und wer Schaden nimmt, wenn das Modell falschliegt, beantwortet kein Framework. Das US-amerikanische National Institute of Standards and Technology zählt Zuverlässigkeit, Datenschutz und schädliche Verzerrungen zu den Aspekten, die über die gesamte Lebensdauer eines KI-Systems berücksichtigt werden müssen. Welche davon besonders wichtig sind, hängt völlig davon ab, was das System für wen tut.
Ein Modell, das Musikempfehlungen sortiert, und ein Modell, das eine medizinische Entscheidung unterstützt, bergen nicht dasselbe Risiko. Keine Bibliothek kennt diesen Unterschied. Menschen wählen die Belege, die Prüfungen, die Grenzen und das Maß an menschlicher Kontrolle.
Pythons Rolle in der KI ist real und groß. Sie ist zugleich bescheidener, als das Marketing vermuten lässt: Python ist der zugängliche Ort, an dem Daten, Werkzeuge, Bewertung und ein Produkt verbunden werden. Die letzte Lektion dieses Kapitels fragt, warum dieselbe Rolle in so vielen Gebieten wiederkehrt.
Mehr erfahren
Die Kurzeinführung in Hugging Face Transformers zeigt die Nutzung eines vortrainierten Modells und das Trainieren eines Modells als getrennte Wege. PyTorchs C+±Übersicht erklärt, wie seine Python- und C+±Teile zusammenpassen. Beide englischen Quellen sind technischer als diese Lektion und optional.