Anfragen von Hand schreiben
Eine URL auseinandernehmen
In Kapitel 1 wurde das Anfrageziel von Hand eingetippt: /v1/items?page=1&page_size=2, mit der Adresse ("practice-api", 8080) getrennt davon in ADDRESS. Eine http://practice-api:8080/v1/items?page=1&page_size=2, und ein Client muss sie auseinandernehmen, bevor er etwas senden kann. Manche Teile entscheiden, wohin die Verbindung geht, manche kommen in die Anfrage, und ein Teil wird überhaupt nie gesendet.
Pythons Standardbibliothek nimmt sie für dich auseinander: urlsplit aus dem urllib.parse. Lass es auf eine URL los, in der jeder Teil ausgefüllt ist:
urlsplit gibt ein parts.port ist die Zahl 8080, ein int; jeder andere Teil ist ein String. Die Trennzeichen sind weg: kein ://, kein : vor dem ? vor der Query, kein # vor dem Fragment.
Wohin jeder Teil gehört
Hier ist dieselbe URL mit jedem Teil beschriftet, und wo er landet. Folge jedem Teil hinunter zur Anfrage ganz unten:
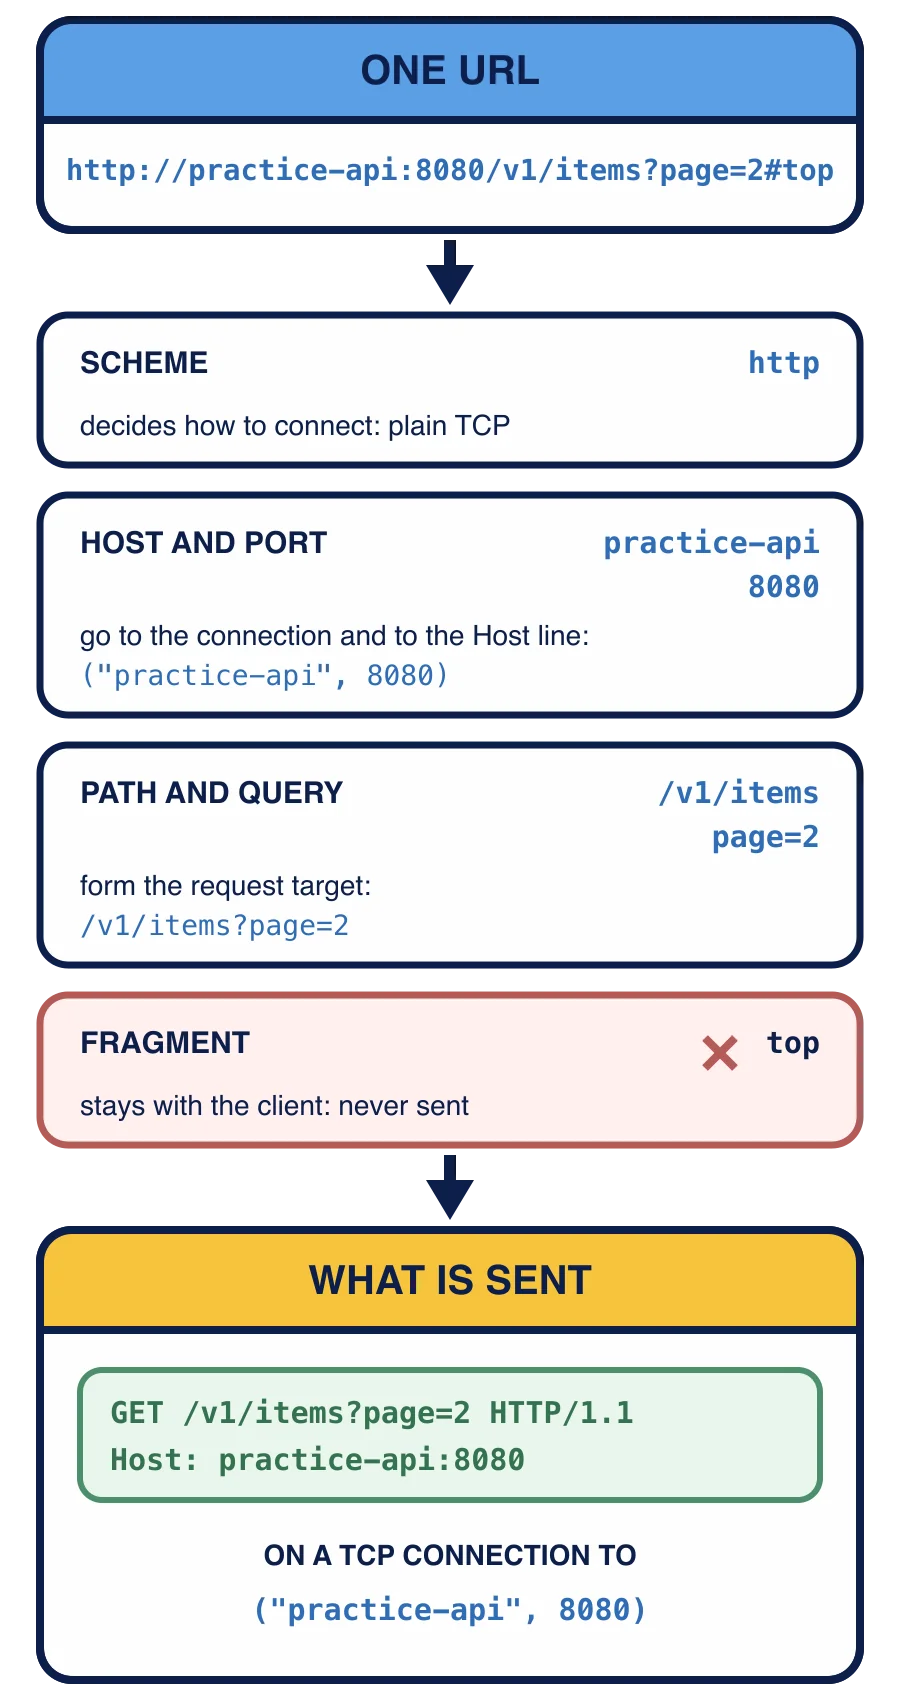
Die Anfrage, die diese URL ergibt, ist GET /v1/items?page=2 HTTP/1.1 mit der Zeile Host: practice-api:8080, gesendet auf einer ("practice-api", 8080). Nichts darin sagt #top.
Schema. http bedeutet einfaches https bedeutet dasselbe HTTP, transportiert in einer verschlüsselten http.
Host und Port. Diese sagen, wohin die Verbindung geht. Der Hostname wird zu einer (host, port) ist das Adresstupel, das deine connect nimmt. Dieselben beiden Host, die Kapitel 1 als HOST_LINE mitgeliefert hat. Lektion 4 erklärt, warum der Server sie noch einmal braucht, wenn die Verbindung ihn schon erreicht hat.
Pfad und Query. Diese werden zum Anfrageziel, dem zweiten Wort der Anfragezeile: der Pfad, dann ? und die Query, wenn es eine gibt. Das ist der einzige Teil der URL, den die Anfragezeile trägt. Es gibt auch eine Form der Anfragezeile, die die ganze URL enthält; sie wird benutzt, wenn ein Client mit einem Proxy spricht, der Anfragen woandershin weiterleitet. Eine Anfrage, die direkt an den Server geht, für den sie bestimmt ist, wie alle deine, trägt nur Pfad und Query.
Fragment. Der Teil nach # zeigt auf eine Stelle im Dokument, etwa eine Überschrift auf einer Webseite. Er ist nur für den Client: Ein Browser benutzt ihn, um zu scrollen, nachdem das Dokument angekommen ist. Er taucht nie in der Anfrage auf.
Welcher Text kommt bei der URL http://practice-api:8080/v1/items?page=2#top als Ziel in die Anfragezeile?
Wenn die URL keinen Port nennt
Die meisten URLs nennen keinen Port. Dann ist parts.port gleich None, und der Client setzt den Standardport für das Schema ein: 80 für http, 443 für https.
books.test ist ein erfundener Name: Namen, die auf .test enden, sind für Beispiele und Tests reserviert und gehören nie zu einer echten Website. urlsplit nimmt den String nur auseinander, also funktioniert es mit jeder URL, ohne den Namen nachzuschlagen oder sich irgendwohin zu verbinden. Dein Client verbindet sich hier mit Port 80, während das None für die Zeile Host trotzdem zählt, wie Lektion 4 zeigt.
urlsplit lässt den Pfad auch leer, wenn die URL direkt nach dem Host endet, wie bei http://books.test. Die Anfragezeile braucht dort trotzdem ein Ziel, und das Ziel für “die Wurzel des Servers” ist /. Lektion 5 behandelt diesen Fall.
Was gibt das aus?
from urllib.parse import urlsplit

parts = urlsplit("http://books.test:9000/shelves/3?sort=title&page=2#notes")
print(parts.path)
print(parts.query)
print(parts.port)
Jeder Teil jeder URL bestand bisher aus einfachen ASCII-Wörtern: items, page=2, fiction. Echte Werte sind nicht so ordentlich. Ein Buchtitel kann ein Leerzeichen, einen Schrägstrich, ein kaufmännisches Und oder einen Buchstaben außerhalb von ASCII enthalten, und jedes davon würde die Anfragezeile kaputtmachen oder ändern, was das Ziel bedeutet. Die nächste Lektion macht solche Werte sicher zum Senden.