Wenn etwas schiefgeht · Abschlussprojekt
Abschlussprojekt: Projekt: Ein Aufruf-Wrapper, der gut scheitert
Lektion 2 bis 6 haben sieben kleine Funktionen gebaut, jede mit einer Aufgabe: call_once sendet einen begrenzten Versuch, should_retry und wait_seconds entscheiden, ob und wie lange gewartet wird, check_finished erkennt eine abgeschnittene Antwort, und estimate_tokens, check_budget und record_usage führen das Budget. call_model ruft sechs davon auf; check_budget ruft estimate_tokens auf. In diesem Projekt setzt du sie in call_model zusammen, der einen Funktion, mit der der restliche Lernassistent das Modell aufrufen wird.
Was call_model verspricht
Eine Funktion, von der anderer Code abhängt, sollte genau sagen, was sie kann. call_model hat sechs mögliche Ergebnisse, und ihr Docstring listet sie auf:
def call_model(request, *, client, sleep, max_attempts, budget):
    """Send request with retries, within budget, and return a complete response.

    Returns the response when an attempt succeeds and the reply is complete.
    Raises BudgetExceeded before any attempt that the budget cannot cover.
    Raises ReplyCutOff when the reply stopped at max_tokens, after counting its tokens.
    Raises an error that is not worth retrying at once.
    Raises a retryable error at once when its wait would be longer than MAX_WAIT.
    Raises the last error when all max_attempts attempts failed.
    """
Auf diese Liste kann sich ein Aufrufer verlassen. Das Quiz aus Lektion 8 weiß zum Beispiel, dass eine Antwort von call_model immer vollständig ist und dass sie dem Budget schon angerechnet wurde.
Die Reihenfolge der Schritte
Für jeden Versuch von 1 bis max_attempts, das mindestens 1 ist:
check_budget(request, budget). Die Prüfung läuft vor jedem Versuch, nicht nur vor dem ersten. Eine Wartezeit zwischen den Versuchen kann Sekunden dauern, und anderer Code, der sich das Budget teilt, kann es in der Zwischenzeit verbrauchen.Sende den Versuch mit
call_once(request, client=client)innerhalb vontry.Bei
openai.APIError:wenn
should_retry(error)falsch ist oder dies der letzte Versuch war, löse den Fehler aus;andernfalls berechne
wait = wait_seconds(error, attempt); wennwaitlänger alsMAX_WAITist, löse den Fehler aus;andernfalls ruf
sleep(wait)auf und mach mit dem nächsten Versuch weiter.
Bei Erfolg
record_usage(response, budget), danncheck_finished(response), dann gib die Antwort zurück.
Das Bild zeigt dieselben Schritte. Jeder Versuch beginnt bei check_budget, der einzige Weg zurück dorthin führt über sleep(wait), und jeder andere Weg beendet den Aufruf.
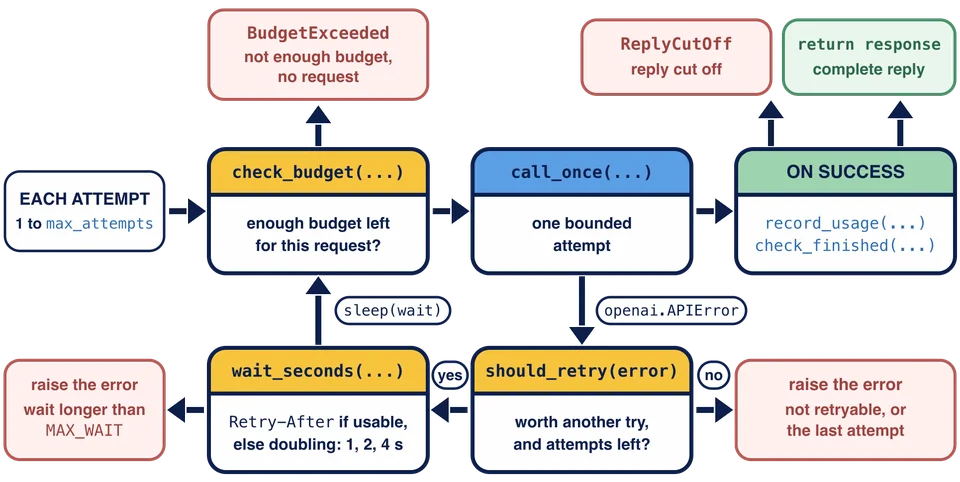
Eine for-Schleife über range(1, max_attempts + 1) gibt attempt bei drei Versuchen die Werte 1, 2, 3. Nach sleep springt continue direkt zum nächsten Versuch, sodass die Erfolgsschritte unter dem try nur laufen, wenn ein Versuch geklappt hat.
raise error löst den abgefangenen Fehler über seinen Namen aus, sodass der Aufrufer den ursprünglichen RateLimitError oder InternalServerError mit Status und Antwort bekommt. Das except fängt openai.APIError ab und nichts Weiteres: Ein Bug in deinem eigenen Code, etwa ein KeyError, ist kein Modellfehler und darf nicht erneut versucht werden.
Drei Details sind wichtig:
sleepwird nach dem letzten Versuch nie aufgerufen. Vor dem Aufgeben noch zu warten, verschwendet die Wartezeit.Der Verbrauch wird einmal erfasst, für die Antwort, die angekommen ist. Ein gescheiterter Versuch hat keinen Verbrauch, den man erfassen könnte.
record_usagekommt vorcheck_finished. Eine abgeschnittene Antwort wurde trotzdem bezahlt, deshalb wird sie gezählt, bevorReplyCutOffausgelöst wird.
sleep ist ein Parameter, wie Lektion 4 gesagt hat. Ein echter Lauf übergibt time.sleep; die Prüfungen übergeben eine Funktion, die jede Wartezeit notiert und sofort zurückkehrt. Die Demonstration übergibt das vorgegebene sleep_and_say aus reliable.py, das jede Wartezeit ausgibt und dann time.sleep aufruft.
Ausführen
Wenn call_model geschrieben ist, führe python chapter9_demo.py aus. Die Demonstration ruft reset_scripted_model() auf und dann viermal call_model mit max_attempts=3. Alle außer dem dritten senden What is a Python list?:
call_model under rate-limit:2:
  (waiting 1.0 s)
  (waiting 1.0 s)
  A list is an ordered, changeable collection of values. You write one with square brackets, like [1, 2, 3], and you can add, remove and change items after creating it.
  Budget: {'limit': 20000, 'used': 48}
call_model under server-error:5, three attempts:
  (waiting 1 s)
  (waiting 2 s)
  InternalServerError: 500
call_model under length:
  ReplyCutOff. The partial text was 'A list is an ordered collection that can'
  Budget: {'limit': 20000, 'used': 18}
call_model with a budget of 500:
  BudgetExceeded: Not enough budget for this call: 500 of 500 tokens are left.
A quiz through call_model:
Run stopped at the next function to build: make_quiz is built in Lesson 8.
Jeder Fall ist eines der dokumentierten Ergebnisse:
Bei
rate-limit:2sind zwei Versuche mit einem429gescheitert, jeweils gefolgt von der einsekündigen Wartezeit, die seinRetry-Afterverlangt hat, und der dritte war erfolgreich. Das Budget zählt nur die Antwort: 48 Tokens.Bei
server-error:5ist jeder Versuch gescheitert. Die Wartezeiten haben sich verdoppelt, 1, dann 2, und nach dem dritten Versuch hatcall_modelden letzten Fehler ausgelöst, ohne eine dritte Wartezeit.Bei
lengthmitExplain Python lists in detail.wurde die Antwort abgeschnitten. Ihre 18 Tokens stehen im Budget, und dann wurdeReplyCutOffausgelöst.Mit einem Budget von 500 lag schon die erste Schätzung bei 805.5, also wurde
BudgetExceededausgelöst und keine Anfrage gesendet.
Die Wartezeiten machen zusammen etwa fünf Sekunden dieser Demonstration aus.
Warum kommt record_usage in call_model vor check_finished?
call_model bekommt max_attempts=3, und jeder Versuch scheitert mit einem 500. Wie oft ruft es sleep auf?
Aufgabe
Schreib in reliable.py die Funktion call_model(request, *, client, sleep, max_attempts, budget). Gib ihr einen Docstring, der ihre Ergebnisse auflistet. Für jeden Versuch von 1 bis max_attempts:
Ruf
check_budget(request, budget)auf.Sende den Versuch mit
call_once(request, client=client)innerhalb vontry.Bei
openai.APIError: Löse den Fehler aus, wennshould_retry(error)falsch ist oder dies der letzte Versuch war. Andernfalls berechnewait_seconds(error, attempt), löse den Fehler aus, wenn die Wartezeit länger alsMAX_WAITist, und ruf sonstsleep(wait)auf und versuch es erneut.Bei Erfolg ruf
record_usage(response, budget)auf, danncheck_finished(response), und gib dann die Antwort zurück.
Ruf sleep nie nach dem letzten Versuch auf, und verwende das sleep, das du bekommen hast, nicht time.sleep. Löse den abgefangenen Fehler selbst mit raise error aus. Führe python chapter9_demo.py aus, um jedes Ergebnis zu sehen, und prüfe dann deine Arbeit.