Den OpenAI-Client verwenden
Was der Client verbirgt
Lektion 1 hat jeden Client mit max_retries=0 gebaut und eine Erklärung versprochen. Hier ist sie, als Experiment, das du ausführen kannst: dieselbe fehlschlagende Anfrage über einen Client, der sofort aufgibt, und über einen, der es erneut versuchen darf.
Ein Dienst, der zweimal fehlschlägt und dann funktioniert
Das geskriptete Modell kann absichtlich und abgezählt fehlschlagen. Mit dem Anfrage-Header X-Scripted-Scenario: server-error:2 bekommen die ersten zwei Anfragen mit diesem Header den Status 500, und jede Anfrage danach bekommt die normale Antwort. Das geskriptete Modell führt diese Zählung für deine Sandbox, also ist die dritte Anfrage erfolgreich, egal welcher Client sie sendet.
Eine Zählung braucht einen Startpunkt. Das mitgelieferte reset_scripted_model() sendet POST /v1/scripted/reset und setzt die Zählung damit auf null zurück. Ohne das würde ein zweiter Lauf von python client_calls.py die Zählung schon jenseits von zwei vorfinden, und die Fehlschläge würden nicht noch einmal passieren.
Die Demonstration sendet den Header bei einzelnen Aufrufen mit extra_headers:
failing = {"X-Scripted-Scenario": "server-error:2"}
messages = [{"role": "user", "content": "What is a Python list?"}]

reset_scripted_model()
client.chat.completions.create(model=MODEL, messages=messages, extra_headers=failing)

reset_scripted_model()
retrying = make_client().with_options(max_retries=2)
response = retrying.chat.completions.create(model=MODEL, messages=messages, extra_headers=failing)
extra_headers= fügt Header nur diesem einen Aufruf hinzu, anders als die default_headers von scenario_client aus Lektion 3, die ein Client bei jedem Aufruf sendet. Der erste Aufruf geht über deinen make_client()-Client, mit max_retries=0. Der zweite geht über eine Kopie davon, erstellt mit with_options(max_retries=2), der Standardeinstellung des Clients. Jeder Aufruf wird mit time.monotonic() gemessen, wie in Kapitel 3.
Ausführen
Sobald du Lektion 4 abgeschlossen hast, führe python client_calls.py aus. Dieser Teil der Ausgabe ist das Experiment:
What the client hides:
With max_retries=0: InternalServerError after 0.0 seconds
With max_retries=2: an answer after 1.7 seconds:
A list is an ordered, changeable collection of values. You write one with square brackets, like [1, 2, 3], and you can add, remove and change items after creating it.
The study chat on the client:
You: What does len() return?
Run stopped at the next function to build: chat_turn is built in Lesson 6.
Die Zeiten können bei deinem Lauf um einige Zehntelsekunden abweichen, weil der Client seine Wartezeiten ein wenig variiert.
Was bei den verborgenen Versuchen passiert ist
Mit max_retries=0 hat die erste Anfrage ihren 500 bekommen, und der Client hat sofort openai.InternalServerError ausgelöst. Dein Code hat den Fehlschlag gesehen.
Mit max_retries=2 passierte der ersten Anfrage dasselbe, und dein Code hat nichts gesehen. Der Client hat knapp eine halbe Sekunde gewartet und die Anfrage erneut gesendet. Auch der zweite Versuch bekam einen 500. Der Client hat knapp eine Sekunde gewartet und sie ein drittes Mal gesendet, und dieser Versuch war erfolgreich. Erst dann ist create zurückgekehrt, mit dem Antworttext. Drei Anfragen haben den Dienst erreicht; dein Code hat einen Aufruf gemacht und eine Antwort bekommen, und die einzige Spur der anderen beiden ist die Zeit, die das gedauert hat.
Das Bild zeigt die beiden Läufe übereinander. Alles innerhalb der Klammer ist während eines einzigen Aufrufs von create passiert.
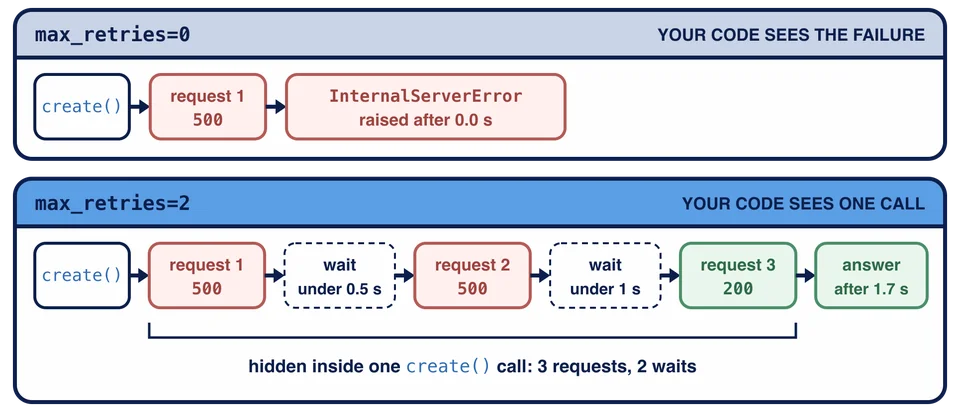
Der Client versucht es von sich aus erneut, wenn eine Anfrage auf eine Weise fehlschlägt, die vorübergehen könnte: Die Verbindung schlägt fehl oder läuft in einen Timeout, oder der Dienst antwortet mit einem Status wie 429 (zu viele Anfragen) oder 500 und höher. Vor jedem neuen Versuch wartet er etwas länger. Mit der Standardeinstellung kann ein Aufruf in deinem Code zu drei Anfragen werden.
Warum dieser Kurs es ausschaltet
Verborgene erneute Versuche sind bequem, und für viele Programme sind sie die richtige Wahl. Bei einem Programm, das ein Sprachmodell aufruft, verbergen sie Dinge, die du sehen musst.
Kosten. Jede Anfrage, die ein Modell erreicht, wird bezahlt, nach den Tokens, die es liest und schreibt. Ein erneuter Versuch nach einem Timeout kann zum Beispiel eine ganze Antwort kosten, die nie angekommen ist. Wenn der Client es von sich aus erneut versucht, kann dein Code diese Anfragen nicht zählen.
Budgets und Zeit. Kapitel 9 gibt dem Lernassistenten ein Budget für Tokens und Zeit. Ein Budget funktioniert nur, wenn der Code, der es einhält, jede Anfrage und jedes Warten sieht. Mehr als eine Sekunde Wartezeit innerhalb eines Aufrufs bleibt für ihn unsichtbar.
Tests. Eine Prüfung, die einen Fehlschlag vorgibt, erwartet einen Aufruf. Mit verborgenen erneuten Versuchen kann derselbe Aufruf gelingen, fehlschlagen oder Sekunden dauern, je nach einer Einstellung, die der Test nie sieht.
Entscheiden, was einen erneuten Versuch wert ist. Ein 500 kann vorübergehen; eine Anfrage, die der Dienst als fehlerhaft zurückweist, wird nie durchgehen, und eine Ablehnung ist die Antwort des Modells, kein Fehlschlag. Kapitel 9 teilt Fehlschläge in solche, die einen weiteren Versuch wert sind, und solche, die es nicht sind, und versucht nur die erste Art erneut, mit Wartezeiten, die dein Code wählt und zählen kann.
Deshalb wird jeder Client in diesem Kurs mit max_retries=0 gebaut, und Fehlschläge erreichen deinen Code. Kapitel 9 fügt die erneuten Versuche wieder hinzu, dort, wo du sie sehen kannst.
Mit max_retries=2 und dem Szenario server-error:2 hat create nach etwa 1.7 Sekunden einen Antworttext zurückgegeben. Was ist in dieser Zeit passiert?
Kapitel 9 fügt ein Budget hinzu, das jede Anfrage und jedes Warten zählt. Warum braucht das Clients, die mit max_retries=0 gebaut sind?
Die Demonstration ruft reset_scripted_model() vor jedem der beiden Aufrufe auf, die server-error:2 verwenden. Was würde sich ohne diese Aufrufe ändern?