LLM-Code testen · Übung
Ein kleines Eval-Set bauen
Deine Tests sagen jetzt, ob der Code stimmt: Er baut die richtigen Anfragen, verarbeitet jede Art von Antwort und hält seine Versprechen für jede Antwort. Sie können nicht sagen, ob die Antworten gut sind. Sind K = 3 Passagen genug? Ist MIN_SCORE = 2 zu streng? Ist die Systemnachricht klar? Jede dieser Fragen ist eine Änderung, die du vornehmen könntest, und eine Antwort davor und eine danach können dir nicht sagen, ob sie geholfen hat.
Eine Eval kann das. Sie ist eine feste Menge von Fragen, jede mit dem, was ein gutes Ergebnis enthalten muss, die durch das Programm laufen und als Erfolgsquote bewertet werden. Ändere den Prompt, führe sie noch einmal aus und vergleiche die Zahlen.
Die zehn Fälle
EVAL_CASES in evals.py enthält zehn Fragen zu den Notizen, jede mit der Notiz, aus der eine gute Antwort stammt:
{"question": "How do I make an independent copy of a list?", "note_id": "03-lists"}
Die Fälle sind vorgegeben und nicht von dir geschrieben, weil das geskriptete Modell nur Fragen beantworten kann, für die es Zeilen hat. Jede Frage betrifft eine andere Notiz, von Strings über Module bis zum Testen.
Einen Fall beantworten
answer_case(question, notes, *, client, k, system, budget), ebenfalls vorgegeben, beantwortet eine Frage. Lies sie in evals.py: Sie ist answer_from_notes aus Kapitel 8 mit zwei Änderungen. Die Systemnachricht ist das Argument system statt immer GROUNDED_SYSTEM, damit Lektion 7 eine andere ausprobieren kann. Und der Aufruf läuft über call_model aus Kapitel 9, mit MAX_ATTEMPTS, time.sleep und dem Budget, das sie bekommt, sodass ein Live-Lauf ein Ratenlimit abwartet und die Tokens jeder Antwort gezählt werden. Wie answer_from_notes gibt sie keine Antwort und fragt das Modell gar nicht erst, wenn die beste Passage unter MIN_SCORE liegt, und sie löst einen ValueError aus, wenn die Antwort ungültig ist oder eine Passage zitiert, die nicht gesendet wurde.
Zwei Punktzahlen
Ein Fall kann an zwei Stellen schiefgehen, deshalb bewertet die Eval beide:
Retrieval: Enthielten die für die Frage gewählten Passagen eine aus der richtigen Notiz? Wenn nicht, hat das Modell die Antwort nie gesehen.
Quellenangaben: Hat die Antwort eine Passage aus der richtigen Notiz zitiert? Dafür muss das Retrieval sie gefunden haben, und dann muss das Modell sie verwendet und richtig zitiert haben.
Das Retrieval kann die Notiz finden, während die Antwort trotzdem scheitert, und eine Antwort kann scheitern, obwohl das Retrieval in Ordnung war. Mit einer einzigen Punktzahl könntest du nicht erkennen, welchen Teil du reparieren musst.
Baue die drei Funktionen
Schreibe in evals.py:
retrieval_hit(case, chunks): GibTruezurück, wenn dienote_idirgendeines Abschnitts inchunksgleichcase["note_id"]ist, sonstFalse.citation_hit(case, answer): GibTruezurück, wenn irgendeine Quellenangabe inanswer.citationsmitcase["note_id"]gefolgt von#beginnt, sonstFalse. Prüfe aufcase["note_id"] + "#", nicht auf die bloße ID, damit ein Fall zu03-listnicht auf03-lists#4passt.run_eval(cases, notes, *, client, k, system):beginne mit
budget = {"limit": EVAL_BUDGET, "used": 0}undresult = {"cases": len(cases), "retrieval": 0, "citations": 0, "misses": [], "tokens": 0};nimm für jeden Fall seine Frage, ermittle
best_chunks(question, note_chunks(notes), k)und rufe daraufretrieval_hitauf;rufe dann innerhalb von
tryanswer_case(question, notes, client=client, k=k, system=system, budget=budget)und auf der Antwortcitation_hitauf. Beiexcept ValueError:wurde die Antwort abgelehnt, was als Fehltreffer bei den Quellenangaben zählt;addiere für jede Prüfung, die getroffen hat, eins zu
result["retrieval"]bzw.result["citations"], und hänge die Frage anresult["misses"]an, wenn eine der beiden danebenlag;setze nach der Schleife
result["tokens"]aufbudget["used"]und gibresultzurück.
Fange nur ValueError ab. Ein Aufruf, der mit einem 500 gescheitert ist, oder ein Lauf, der sein Budget erreicht hat, sagt nichts über die Qualität der Antworten aus, also werden diese Fehler weitergereicht und beenden die Eval.
Die Eval ausführen
Führe python evals.py aus. Nach der Aufzeichnung aus Lektion 4 führt die Demonstration dein run_eval über EVAL_CASES mit GROUNDED_SYSTEM und K aus und gibt das Ergebnis mit dem vorgegebenen print_eval aus:
The eval with GROUNDED_SYSTEM:
GROUNDED_SYSTEM: retrieval 9 of 10, citations 7 of 10, 3148 tokens
  missed: Why should a default argument never be a list?
  missed: How does pytest find my tests?
  missed: How do I filter items with a list comprehension?
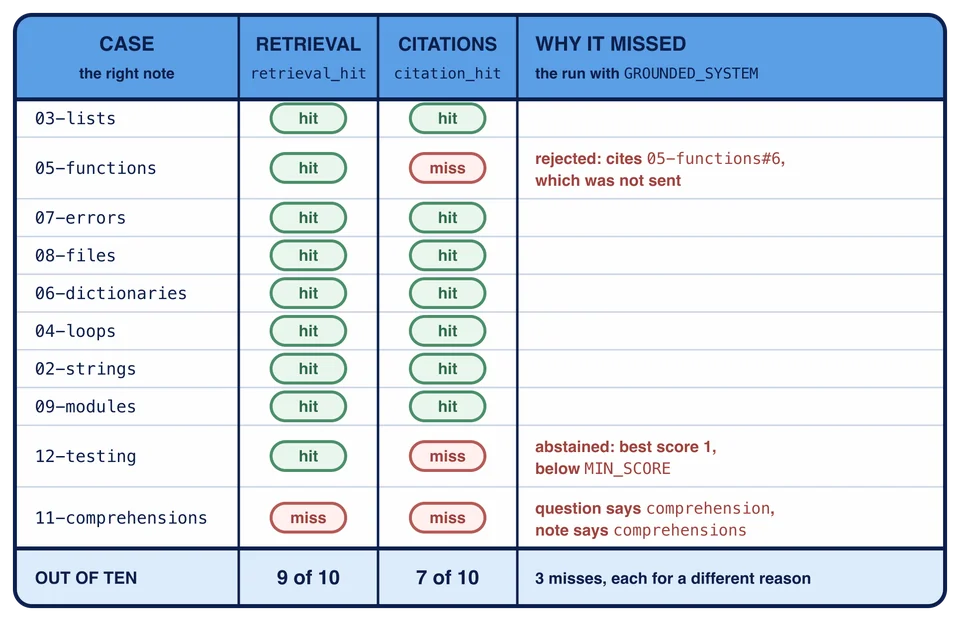
Danach folgt ein Vergleich zweier Systemnachrichten; der gehört zu Lektion 7. Neun von zehn beim Retrieval, sieben von zehn bei den Quellenangaben und drei Fehltreffer, jeder aus einem anderen Grund:
Why should a default argument never be a list? Das Retrieval hat die Notiz über Funktionen gefunden, aber die Antwort zitiert
05-functions#5und05-functions#6, und die zweite war nicht unter den drei gesendeten Passagen (05-functions#5,01-variables#2und05-functions#4).parse_cited_answerlehnt sie ab, also ist es ein Fehltreffer bei den Quellenangaben. Das ist dieselbe Antwort, die auch Kapitel 8 abgelehnt hat.How does pytest find my tests? Die beste Passage erreicht nur 1 Punkt, unter
MIN_SCORE, also gibtanswer_casekeine Antwort und fragt nichts. Die Notiz über das Testen war unter den drei Passagen, an zweiter Stelle, also zählt das Retrieval als Treffer, aber „Ich weiß es nicht“ zitiert nichts.How do I filter items with a list comprehension? Das Retrieval lag daneben: Die Frage sagt
comprehension, die Notiz sagtcomprehensions, und der Wortabgleich aus Kapitel 8 behandelt das als verschiedene Wörter. Das Modell bekam Passagen aus den Notizen über Listen und Schleifen, sagte, dass sie die Frage nicht beantworten, und zitierte nichts. Beide Punktzahlen liegen daneben.
Die Eval hat 9 Anfragen gestellt, weil der pytest-Fall nichts gefragt hat, und sie haben insgesamt 3148 Tokens verbraucht.
Die Tabelle stellt die beiden Punktzahlen für alle zehn Fälle nebeneinander. Lies eine Spalte von oben nach unten für ihre Summe und die drei Zeilen mit einem Fehltreffer von links nach rechts: Jede ist an einer anderen Stelle gescheitert.
Füge einen eigenen Fall hinzu
Du kannst EVAL_CASES einen Fall hinzufügen und die Eval noch einmal ausführen. Das Retrieval wird für jede Frage gleich bewertet, also zeigt dir ein neuer Fall, was der Wortabgleich findet. Das geskriptete Modell hat allerdings nur für diese zehn Antworten. Auf jede andere Frage sendet es sein Echo, das kein JSON ist, also wird die Antwort abgelehnt und der Fall ergibt einen Fehltreffer bei den Quellenangaben. Das liegt am geskripteten Modell, nicht an deiner Frage. Die Prüfung deiner Arbeit verwendet eigene Fälle, also ändert ein Fall, den du hinzufügst, dort nichts.
Wie deine Arbeit geprüft wird
Die Prüfungen verwenden unbekannte Notizen und Fälle und den Fake-Client, mit dem vorgegebenen answer_case, das die Prüfung selbst einsetzt (mit einem Sleep, der nur aufzeichnet). Sie prüfen retrieval_hit und citation_hit mit Beinahe-Treffern und leeren Listen; und bei run_eval die Zählungen, die Fehltreffer in der Reihenfolge der Fälle, die Tokens, dass ein Fall, bei dem keine Antwort gegeben wird, keine Anfrage stellt, dass eine abgelehnte Antwort als Fehltreffer zählt, ohne die Eval zu beenden, dass ein 500 bei jedem Versuch weitergereicht wird, dass jeder Lauf mit einem frischen Budget aus EVAL_BUDGET beginnt und dass k und system in den Anfragen ankommen.
Der Fall How do I filter items with a list comprehension? verfehlt Retrieval und Quellenangaben. Was solltest du dir zuerst ansehen?
Warum fängt run_eval um answer_case herum nur ValueError ab?
Aufgabe
Schreibe in evals.py:
retrieval_hit(case, chunks):True, wenn dienote_idirgendeines Abschnitts gleichcase["note_id"]ist.citation_hit(case, answer):True, wenn irgendeine Quellenangabe inanswer.citationsmitcase["note_id"] + "#"beginnt.run_eval(cases, notes, *, client, k, system): Beginne mitbudget = {"limit": EVAL_BUDGET, "used": 0}undresult = {"cases": len(cases), "retrieval": 0, "citations": 0, "misses": [], "tokens": 0}. Bewerte für jeden Fallretrieval_hitaufbest_chunks(question, note_chunks(notes), k); rufe dann innerhalb vontryanswer_case(question, notes, client=client, k=k, system=system, budget=budget)auf und bewertecitation_hit, wobei einValueErrorals Fehltreffer zählt. Zähle jeden Treffer, hänge die Frage anmissesan, wenn eine der beiden Prüfungen danebenlag, setze am Enderesult["tokens"] = budget["used"]und gibresultzurück. Fange nichts außerValueErrorab.
Führe python evals.py aus, um die Punktzahlen der Eval zu sehen, und prüfe dann deine Arbeit.