Ab nach Hause
Vor dem Start ein Ausgabenlimit setzen
Beim Kursmodell kostet ein Fehler nichts. Eine Schleife, die nie aufhört, ein erneuter Versuch, der sich zu oft wiederholt, oder ein Prompt, der mit jeder Runde wächst, verschwendet nur ein wenig Zeit. Bei einem echten Anbieter wird jeder dieser Fehler berechnet. Bevor das Programm seinen ersten bezahlten Aufruf macht, leg fest, wie viel es ausgeben darf, und setze ein Limit auf jeder Ebene, auf der etwas schiefgehen kann.
Vier Limits, von außen nach innen
Das Guthabenlimit des Schlüssels
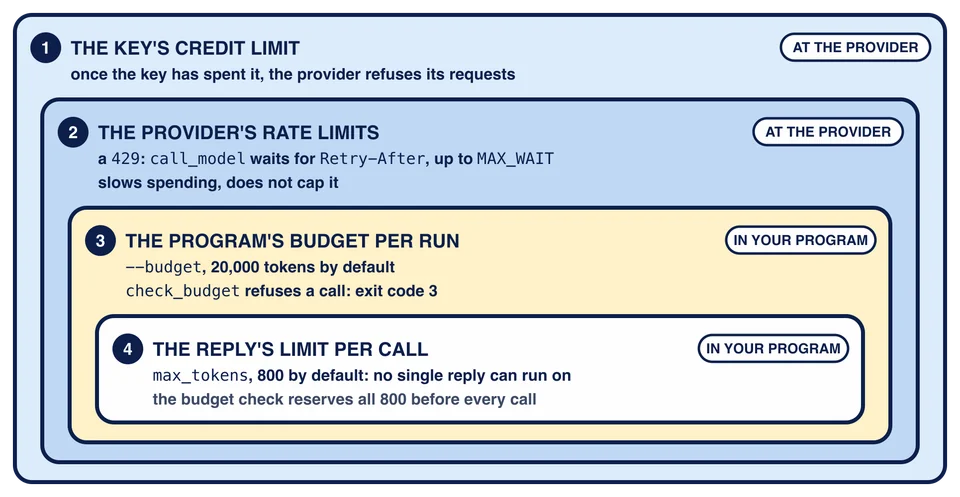
Das äußerste Limit liegt beim Anbieter. Bei OpenRouter kannst du jedem Schlüssel ein eigenes Guthabenlimit (credit limit) geben: Sobald der Schlüssel so viel ausgegeben hat, lehnt der Anbieter seine Anfragen ab. Setze es vor dem ersten Aufruf, auf einen kleinen Betrag, dessen Verlust dich nicht stören würde.
Das ist das Limit, das auch dann noch greift, wenn alles andere falsch ist: ein Bug in deiner Schleife, ein zu hoch gesetztes Budget, ein geleakter Schlüssel, den jemand anderes benutzt. Nichts in deinem Code kann es abschalten, weil es nicht in deinem Code steht. Das eigene Live-Modell des Kurses funktioniert genauso: Sein Schlüssel hat ein eigenes Guthabenlimit, als Absicherung hinter den Limits, die der Dienst setzt.
Die Ratenlimits des Anbieters
Anbieter begrenzen auch, wie viele Anfragen du pro Minute schickst, manchmal auch pro Tag. Wer eins überschreitet, bekommt ein 429. Dein Programm geht schon damit um: call_model aus Kapitel 9 wartet die Zeit im Header Retry-After ab und versucht es erneut, bis zu MAX_WAIT (60 Sekunden), und gibt mit Exit-Code 1 auf, wenn der Anbieter eine längere Wartezeit verlangt. Ein Ratenlimit schützt den Anbieter und bremst deine Ausgaben, aber es deckelt sie nicht.
Das Live-Modell des Kurses ist ein Beispiel für Limits, die ein Dienst für seine Nutzer setzt: zehn Anfragen pro Minute, eine tägliche Anzahl an Anfragen und Tokens und eine tägliche Kostenobergrenze. In Kapitel 9 sind dir die ersten beiden als 429-Antworten mit einem kurzen und einem langen Retry-After begegnet.
Das Budget des Programms pro Lauf
--budget ist das eigene Limit des Lernassistenten, 20000 Tokens pro Lauf, wenn du keine andere Zahl übergibst. Jeder Modellaufruf des Laufs zehrt von diesem einen Budget, und check_budget aus Kapitel 9 lehnt einen Aufruf ab, bevor er gesendet wird, wenn seine Schätzung nicht in den Rest passt. Ein abgelehnter Aufruf beendet den Lauf mit Exit-Code 3.
Das Limit der Antwort pro Aufruf
Jeder Aufruf schickt max_tokens mit, DEFAULT_MAX_TOKENS (800), sofern die Anfrage nichts anderes sagt, damit keine einzelne Antwort ausufern kann. Die Budgetprüfung reserviert vor jedem Aufruf diese ganze Menge, weil die Antwort so lang werden könnte. Deshalb kann ein Lauf abgelehnt werden, obwohl reichlich Platz für die Antwort gewesen wäre, die er tatsächlich bekommen hätte: Die Prüfung muss für die längste Antwort gelten, die die Anfrage zulässt, und kann nicht im Voraus wissen, dass diese hier kurz gewesen wäre.
Das Bild verschachtelt die vier Limits. Jedes wirkt innerhalb der Limits um es herum, und nur die äußeren beiden liegen außerhalb deines Codes. Deshalb greift das Guthabenlimit des Schlüssels auch dann noch, wenn dein Programm falsch ist.
Was ein Lauf kostet
Kapitel 10, Lektion 1 hat eine Live-Antwort von openai/gpt-oss-20b gezeigt, die 72 Eingabe-Tokens und 206 Ausgabe-Tokens verbraucht hat. OpenRouter hat ihre Kosten mit $0.0000310 angegeben. Zu den Listenpreisen des Modells am 08.11.2026, $0.03 pro Million Eingabe-Tokens und $0.13 pro Million Ausgabe-Tokens, hätte sie $0.0000289 gekostet. Der Unterschied verrät, dass der Endpunkt, der geantwortet hat, etwa $0.14 pro Million Ausgabe-Tokens berechnet hat. OpenRouter schickt eine Anfrage an einen von mehreren Endpunkten für ein Modell, und nicht alle berechnen dasselbe.
Mit dem Preis, der tatsächlich berechnet wurde, würde ein ganzer Lauf, der sein volles Standardbudget verbraucht, etwa Folgendes kosten:
20,000 × $0.14 / 1,000,000 = $0.0028
Das sind etwa $0.003 pro Lauf, je nachdem, welchen Endpunkt OpenRouter wählt. Die Rechnung zählt jedes Token zum Ausgabepreis, dem höheren der beiden, also liegt sie eher zu hoch. Trotzdem ist sie eine Schätzung, keine feste Obergrenze. Das Budget zählt Zeichen geteilt durch vier, was nah an der Zählweise des Anbieters liegt, aber nicht genau gleich ist, und es lässt die Tool-Beschreibungen weg, die ask bei jedem Agentenschritt mitschickt und die der Anbieter sehr wohl zählt. Ein Live-Lauf kann etwas über --budget enden.
Die meisten Läufe verbrauchen weit weniger: ask aus Kapitel 11 hat auf dem Kursmodell 539 Tokens verbraucht. Aber der Preis hängt vom Modell ab. Ein anderes Modell kann pro Token hundertmal mehr kosten, also lies den Preis eines Modells beim Anbieter nach, bevor du das Programm darauf richtest.
Zahlen, die du zu Hause neu prüfen solltest
Der Kurs hat seine Zahlen für das Kursmodell gewählt, das in deutlich unter einer Sekunde antwortet und Tokens nach einer einfachen Regel zählt. Sobald das Projekt dir gehört, sind das die Einstellungen, die du dir noch einmal ansehen solltest, alle in deinen eigenen Dateien:
CLIENT_TIMEOUTinclient_calls.py, 10 Sekunden. Ein langsamerer Anbieter oder ein größeres Modell braucht vielleicht länger; Kapitel 9 hat gezeigt, wie ein Timeout aussieht.DEFAULT_MAX_TOKENSinreliable.py, 800. Ein Reasoning-Modell verbraucht einen Teil seinermax_tokensmit Nachdenken, bevor es die Antwort schreibt, also kann eine lange Antwort abgeschnitten werden, wo die des Kursmodells es nie wurde.MAX_WAITinreliable.py, 60 Sekunden: die längste Wartezeit bei einem Ratenlimit, bevor das Programm aufgibt.--budgetauf der, standardmäßig 20000 Tokens.
Ändere eine nach der anderen, und sieh dir vorher und nachher das Log deiner Läufe an. Lektion 4 fügt dieses Log hinzu.
Dein Agent hat einen Bug: Er fordert immer weiter Tools an, und eine versehentliche Änderung hat --budget auf 10000000 gesetzt. Welches Limit stoppt die Ausgaben trotzdem?
Was kostet ein Lauf auf openai/gpt-oss-20b ungefähr, wenn er sein ganzes Standardbudget verbraucht, und warum ist die Zahl nicht exakt?
Ein Lauf hat noch 700 Tokens Budget übrig. Der Text des nächsten Aufrufs umfasst etwa 100 Tokens, und die tatsächliche Antwort hätte 50 Tokens gehabt. Warum lehnt die Budgetprüfung ihn ab?