Kapitel 11
Abschlussprojekt
Die Aufgabe für das Abschlussprojekt
Du hast jedes Teil des Lernassistenten gebaut. Er beantwortet Fragen aus den Notizen mit einem Agenten und einem Such-Tool, schreibt Quizze, streamt einen Chat, übersteht Ratenlimits und abgebrochene Streams, bleibt innerhalb eines Token-Budgets und hat Tests, die kein Netzwerk brauchen. Aber es gibt noch kein Programm, das ein Mensch starten kann. Jedes Teil ist eine Funktion, die von einer anderen Funktion aufgerufen wird.
In diesem Kapitel setzt du die Teile in geprüften Etappen zu einem Kommandozeilenprogramm zusammen, study_assistant.py. Diese Lektion enthält die Aufgabe: was das fertige Programm können muss, welche Teile vorgegeben sind und wie es geprüft wird.
Dein Projekt für dieses Kapitel
Öffne study_assistant.py im Projekteditor. Das ist das Programm, das du in diesem Kapitel fertigstellst. Oben importiert es, was es aus den Kursdateien braucht, die du früher gebaut hast, und legt dann sieben Namen fest:
BASE_URL = "http://llm-api:8080/v1"
MODEL = "pl-scripted"
API_KEY_ENV = "STUDY_ASSISTANT_API_KEY"
NOTES_DIR = Path("notes")

DEFAULT_BUDGET = 20000
ASK_TOOLS = {"search_notes": search_notes, "read_note": read_note}
ASK_MAX_STEPS = 6
Darunter stehen fünf Funktionen als fertiger Code, den diese Lektion durchliest: positive_int, question_count, build_parser, use_settings und build_client. Die anderen zehn sind unfertig. Die Lektionen 2 bis 6 bauen sie, und Lektion 6 schließt die Datei mit der Zeile ab, die das Programm startet.
Die anderen Dateien sind vorgegeben. reliable.py ist die Aufrufrichtlinie aus Kapitel 9, mit einer Änderung, die du in Lektion 4 kennenlernst, und alles, was sie importiert, liegt wie zuvor daneben. evals.py und der Ordner tests sind die fertige Eval und die Tests aus Kapitel 10. fakes.py ist der Fake-Client. stages.py ist die Demonstration dieses Kapitels, die du in der Shell mit python stages.py startest: Sie ruft jede Etappe von study_assistant.py auf, sobald es sie gibt, so wie die Demonstrationen der früheren Kapitel. Die Prüfung deiner Arbeit verwendet eigene Kopien all dieser Dateien. Eine Änderung daran kann also keine Bewertung beeinflussen, aber sie kann stages.py lahmlegen.
Die Aufgabe
Das fertige Programm hat drei Befehle, die du im python study_assistant.py eintippst:
$ python study_assistant.py ask "How do I make an independent copy of a list?"
Use scores.copy() or list(scores). Both build a new list, so a change made through one name no longer shows through the other.

Sources: 03-lists#4
$ python study_assistant.py quiz 03-lists --count 2
$ python study_assistant.py chat
ask QUESTIONstartet den Agenten mit zwei Tools,search_notesundread_note, und gibt seine Antwort aus, dann eine Leerzeile und nachSources:die Labels der Passagen, die er verwendet hat. Eine Antwort darf nur eine Passage zitieren, die eine Suche im selben Lauf zurückgegeben hat. Wenn die erste Antwort gegen diese Regel verstößt oder kein gültiges JSON ist, sagt das Programm dem Modell, was falsch war, und fragt noch einmal. Eine Antwort ohne Quellenangaben ist erlaubt und gibtSources: noneaus.quiz NOTE_IDschreibt ein Multiple-Choice-Quiz über eine Notiz, mit--count NFragen, von 1 bis 5. Standard ist 3.chatliest pro Zeile eine Frage, die du eintippst, streamt jede Antwort und führt das Gespräch weiter, bis du eine leere Zeile eingibst.
--budget TOKENS, vor dem Befehl geschrieben, legt fest, wie viele Tokens ein Lauf höchstens verbrauchen darf. Standard ist 20000, und jeder Modellaufruf des Laufs zehrt von diesem einen Budget, auch der zweite Versuch von ask.
Das Bild zeigt, wie das Programm aufgebaut ist und welche Lektion welchen Teil baut. main führt einen Befehl aus, jeder Befehl besteht aus Funktionen, die du in früheren Kapiteln geschrieben hast, und jeder Modellaufruf geht über die Aufrufrichtlinie aus Kapitel 9 mit dem einen Budget des Laufs.
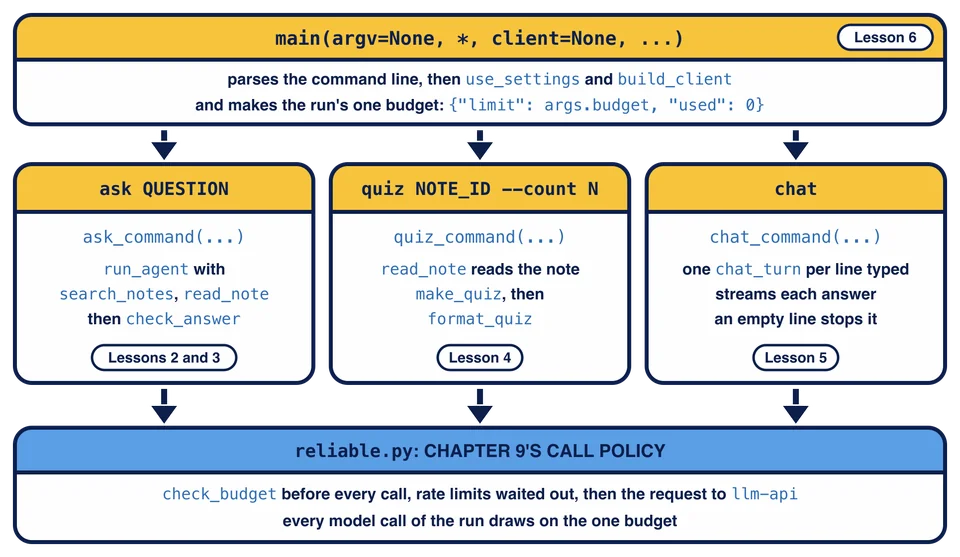
Das Programm schreibt in zwei Streams, wie die Programme aus Python in der Praxis. Antworten, Quizze und der Chat gehen auf die Standardausgabe. Wenn etwas schiefgeht, schreibt das Programm eine Zeile auf die Standardfehlerausgabe: Error: gefolgt von einer kurzen Beschreibung des Problems. ask und quiz geben dann nichts auf der Standardausgabe aus; chat behält, was es schon ausgegeben hat, auch den Anfang einer abgebrochenen Antwort. Danach endet das Programm mit einem Exit-Code, der sagt, welche Art von Fehler es war:
| Code | Bedeutung | Beispiele |
|---|---|---|
0 | es hat funktioniert | eine Antwort, ein Quiz, ein beendeter Chat |
1 | der Lauf ist fehlgeschlagen | der Agent hat ohne Antwort aufgehört, eine Antwort ist auch nach dem erneuten Versuch ungültig, eine Antwort wurde bei max_tokens abgeschnitten, ein abgebrochener Stream, ein Modellfehler, den erneute Versuche nicht behoben haben |
2 | die | eine fehlende Frage, --count 9 |
3 | das Budget ist aufgebraucht | --budget 1000 für eine Frage, die mehr braucht |
4 | die Notiz existiert nicht | quiz 99-magic |
Im Terminal zeigt echo $? direkt nach einem Befehl den Code, mit dem der letzte Befehl geendet hat.
Der Einstiegspunkt ist eine einzige Funktion:
def main(argv=None, *, client=None, notes_dir=NOTES_DIR, stdin=None, sleep=time.sleep):
Sie parst argv, führt den Befehl aus und gibt den Exit-Code zurück. Wird sie ohne Argumente aufgerufen, wie es das Programm beim Start tut, liest sie die echte Kommandozeile, baut den echten Client, liest deine Tastatur und wartet wirklich. Mit den Schlüsselwortargumenten kann ein Test jedes dieser Dinge ersetzen.
Befehle mit eigenen Argumenten
In Python in der Praxis hast du Parser mit Positionsargumenten und Optionen gebaut. Dieses Programm braucht noch etwas mehr. Das erste Wort nach den Optionen ist der Name eines Befehls, ein Wort, das sagt, welche Aufgabe zu erledigen ist, und jeder Befehl hat eigene Argumente: ask nimmt eine Frage, quiz eine Notiz-ID und --count, und chat nimmt nichts. argparse nennt das Subcommands. Hier ist das vorgegebene build_parser, gekürzt auf die wichtigen Teile:
parser = argparse.ArgumentParser(prog="study_assistant.py", description="...", allow_abbrev=False)
parser.add_argument("--budget", type=positive_int, default=DEFAULT_BUDGET, metavar="TOKENS", help="...")
commands = parser.add_subparsers(dest="command", required=True, metavar="COMMAND")
ask = commands.add_parser("ask", help="...", allow_abbrev=False)
ask.add_argument("question", metavar="QUESTION", help="the question, in quotes")
quiz = commands.add_parser("quiz", help="...", allow_abbrev=False)
quiz.add_argument("note_id", metavar="NOTE_ID", help="the id of a note, such as 03-lists")
quiz.add_argument("--count", type=question_count, default=3, metavar="N", help="...")
commands.add_parser("chat", help="...", allow_abbrev=False)
add_subparsers gibt ein Objekt zurück, dessen Methode add_parser einen Befehl hinzufügt und einen Parser dafür zurückgibt, sodass ask.add_argument(...) diesem Befehl eigene Argumente gibt. dest="command" sagt, wo das geparste Ergebnis den Namen des Befehls speichert: Nach ask "What is a tuple?" ist args.command gleich "ask" und args.question gleich "What is a tuple?". Nach quiz 03-lists ist args.command gleich "quiz", args.note_id gleich "03-lists" und args.count gleich 3. required=True macht einen fehlenden Befehl zu einem Bedienungsfehler. --budget gehört zum obersten Parser und steht deshalb vor dem Befehl.
allow_abbrev=False verhindert, dass argparse eine abgekürzte Option wie --cou für --count akzeptiert. Auch der Parser jedes Befehls braucht das, weil der Parser eines Subcommands diese Einstellung nicht vom obersten Parser übernimmt. prog="study_assistant.py" legt den Programmnamen in der Usage-Zeile fest, egal welche Datei das Programm startet.
positive_int und question_count folgen dem Muster aus Python in der Praxis für den type einer Option: Beide wandeln den Text mit int innerhalb von try um und lösen argparse.ArgumentTypeError mit einer kurzen Regel aus, wenn ein Wort keine Zahl ist oder eine Zahl außerhalb des erlaubten Bereichs liegt. argparse gibt diese Regel nach dem Namen der Option aus, zeigt die Usage-Zeile auf der Standardfehlerausgabe und beendet das Programm mit Code 2, bevor dein Code überhaupt läuft. Daher kommt Exit-Code 2: Du schreibst ihn nie selbst.
Sobald Lektion 6 die Zeile hinzugefügt hat, die main startet, gibt --help Folgendes aus:
$ python study_assistant.py --help
usage: study_assistant.py [-h] [--budget TOKENS] COMMAND ...

Answer questions from the course notes, quiz yourself and chat.

positional arguments:
  COMMAND
    ask            answer a question from the notes, with sources
    quiz           write a multiple-choice quiz about one note
    chat           chat about Python, one question per line

options:
  -h, --help       show this help message and exit
  --budget TOKENS  the most tokens this run may use (default: 20000)
$ python study_assistant.py quiz --help
usage: study_assistant.py quiz [-h] [--count N] NOTE_ID

positional arguments:
  NOTE_ID     the id of a note, such as 03-lists

options:
  -h, --help  show this help message and exit
  --count N   how many questions, from 1 to 5 (default: 3)
Bis dahin definiert die Datei nur Funktionen, also gibt ein Start nichts aus.
Einstellungen, die das Programm setzt
Jede Kursdatei hat ihre eigenen Namen. Als reliable.py from client_calls import MODEL ausgeführt hat, hat Python einen Namen MODEL innerhalb von reliable angelegt, und run_agent, make_quiz und chat_turn lesen genau diesen. read_note und note_ids lesen NOTES_DIR in tools.py, und search_notes liest NOTES_DIR in retrieval.py. Das Programm hat sein eigenes MODEL und seinen eigenen Notizordner, also muss es die Namen setzen, die diese Funktionen lesen. Das vorgegebene use_settings(notes_dir) erledigt das, über das jeweilige Modul:
reliable.MODEL = MODEL
tools.NOTES_DIR = notes_dir
retrieval.NOTES_DIR = notes_dir
Deshalb importiert study_assistant.py neben den Funktionen, die es verwendet, auch die Module selbst, mit import reliable, import retrieval und import tools. Den Namen eines Moduls so von außen zu ändern, verliert man leicht aus dem Blick. Darum macht das Programm es an einer einzigen Stelle, am Anfang von main, und nirgends sonst.
build_client() gibt denselben Client zurück wie make_client() aus Kapitel 5, gebaut aus der BASE_URL dieser Datei: OpenAI(base_url=BASE_URL, api_key="sandbox", timeout=CLIENT_TIMEOUT, max_retries=0). Das Kursmodell prüft keinen Schlüssel. Kapitel 12 liest einen echten Schlüssel aus der Umgebungsvariable, die API_KEY_ENV nennt.
Wie geprüft wird
Die Prüfungen starten dein Programm so, wie die Tests aus Kapitel 10 run_agent gestartet haben: Sie rufen main mit einer Liste von Argumenten auf, mit einem FakeClient mit geskripteten Antworten, einem temporären Notizordner mit Notizen, die du nie gesehen hast, getippter Eingabe aus io.StringIO und einem sleep, das seine Wartezeiten nur aufzeichnet. Dann sehen sie sich den Exit-Code, die Standardausgabe und die Standardfehlerausgabe an. Nichts erreicht llm-api, und nichts wartet wirklich. Dafür sind die Schlüsselwortargumente von main da.
Die Lektionen 2 bis 6 bauen jeweils eine Etappe und werden mit den eigenen Versionen der früheren Etappen geprüft, die die Prüfung mitbringt. So wird ein Fehler in der Lektion gemeldet, in der er entstanden ist. Lektion 7 prüft das ganze Programm, ohne etwas von dir zu ersetzen. Lektion 8 führt die Eval aus Kapitel 10 mit den fertigen Einstellungen aus.
Ausführen
Führe in der Shell python stages.py aus. Es beginnt mit dem Block von Lektion 2. Es startet den Agenten mit den Einstellungen von ask für die Kopierfrage über das Kursmodell, gibt seinen Trace mit print_trace aus Kapitel 7 aus und hält bei der ersten Funktion an, die du noch nicht gebaut hast:
Lesson 2: the agent's run for the copy question
Step 1 (159 tokens)
  search_notes {"query": "independent copy of a list"} -> 763 characters
Step 2 (380 tokens)
  answered
Run stopped at the next function to build: trace_labels is built in Lesson 2.
Was steht nach python study_assistant.py ask "What is a tuple?" in args.command?
Mit welchem Exit-Code endet python study_assistant.py quiz 03-lists --count 9, und woher kommt er?
Warum nimmt main ein Argument client, statt immer build_client() aufzurufen?